Könüllü Vergi Əməletməsi Ölçmə Sistemi kimi: Sübut, İdentifikasiya, Risk Qiymətləndirməsi və Proqnozlaşdırma
Bir əməletmə dərəcəsi dörd ayrı statistik obyekti gizlədir: ölçmə, səbəbiyyət çıxarışı, risk skoru və proqnozlaşdırma - işlək kodla birlikdə.
Əksər vergi sistemləri ödənilməli olan məbləğin böyük qismini heç kimi yoxlamadan, məhkəməyə cəlb etmədən, hətta onlarla əlaqə belə saxlamadan toplayır. Bu fenomenin bir adı var: könüllü əməletmə. Çox vaxt bu termin elə işlədilir ki, sanki vergi idarəsinin məlumat bazasından rahatlıqla çıxarıla bilən sadə bir kəmiyyətdir. Lakin bu, belə deyil. Vergi idarəsi yalnız qeydiyyatları, bəyannamələri, bəyan edilmiş öhdəlikləri, ödənişləri, borcları, yoxlama düzəlişlərini, məlumat uyğunsuzluqlarını və məcburetmə tədbirlərini görə bilir. O, sadəcə ödənilməli məbləği qiymətləndirə bilər. İnsanların vergi sistemini nə dərəcədə legitim qəbul etdiklərini və ödəməyə nə dərəcədə meylli olduqlarını sorğu vasitəsilə öyrənə bilər. Lakin bu obyektlərin heç biri "könüllü əməletmə" anlayışının özünü birbaşa əks etdirmir.
Bu fərq böyük əhəmiyyət daşıyır, çünki vizual olaraq eyni görünən nəticə tamamilə fərqli mexanizmlərin məhsulu ola bilər. Məsələn, vergilərin vaxtında ödənilmə göstəricisinin yüksək olması verginin mənbədə tutulması, üçüncü tərəflərin hesabatlılığı, bəyannamələrin əvvəlcədən doldurulması, qayda pozuntularının aşkar ediləcəyinə dair yaranmış qəti inam, aşağı əməliyyat xərcləri, daxili motivasiya və ya bütün bunların kombinasiyası ilə bağlı ola bilər. ABŞ-nin Daxili Gəlirlər Xidməti (IRS) 2022-ci vergi ili üçün könüllü əməletmə səviyyəsini 85,0 faiz proqnozlaşdırır və bunu könüllü olaraq vaxtında ödənilmiş verginin qiymətləndirilmiş həqiqi vergi məbləğinə nisbəti kimi tərif edir. Baxmayaraq ki, ifadənin səslənişi fərqli məna təlqin edir, əslində bu, sırf mühasibat uçotuna əsaslanan bir anlayışdır və heç bir halda psixoloji meylin ölçüsü sayıla bilməz.
Bu məqalədə könüllü əməletmə üzrə etibarlı və elmi əsaslı kəmiyyət proqramının real arxitekturası addım-addım qurulur. Çox vaxt tək bir rəqəmə sığışdırılan, lakin əslində vahid inzibati verilənlər toplusu vasitəsilə cavablandırıla bilən dörd fərqli sual bir-birindən fərqləndirilir: əməletmənin səviyyəsi nə qədərdir, onu nə dəyişir, hansı hallar qayda pozuntusu riski daşıyır və növbəti ildə aqreqat göstərici necə olacaq. Bu dörd suala müvafiq olaraq ölçmə modelləri, səbəb-nəticə dizaynları, risk skorları və proqnozlar cavab verir və onların nəticələrini bir-biri ilə əvəzləmək olmaz. Aşağıda təqdim edilən hər bir kod bloku tam işləkdir və altındakı rəqəmlər həmin kodun birbaşa icra nəticəsidir.
İfadənin əsl mənası və ən çox qarışdırıldığı anlayışlar
Ən düzgün başlanğıc nöqtəsi vergi idarəçiliyi diaqnostikasında tətbiq edilən dörd sütunlu quruluşdur: vergi ödəyiciləri qaydalara uyğun qeydiyyatdan keçməli, bəyannamələri vaxtında təqdim etməli, öhdəliklərini dəqiq bəyan etməli və yaranan borcu vaxtında ödəməlidirlər. Bu öhdəliklər bir-birindən tamamilə müstəqildir. Vergi ödəyicisi bəyannaməni vaxtında təqdim etdiyi halda gəlirini az göstərə, gəlirini dəqiq bəyan etdiyi halda vergini gec ödəyə və ya ümumiyyətlə vergi reyestrindən kənarda qala bilər. Məhz buna görə də, TADAT diaqnostika çərçivəsi bu amilləri tək bir dəyişən daxilində birləşdirmək əvəzinə, hər birini ayrı-ayrılıqda performans göstəricisi kimi qiymətləndirir.
Deməli, dövründəki vergi ödəyicisi üçün nəticə sadə skalyar deyil, bir vektordur:
burada , , və müvafiq olaraq qeydiyyatı, bəyannamələrin təqdim edilməsini, dəqiqliyi və ödənişi ifadə edir. Lakin bu düstur belə əsas bazaları (məxrəcləri) tam əks etdirmir. Məsələn, vaxtında təqdimetmə göstəricisini hesablamaq üçün faktiki alınan deyil, gözlənilən bəyannamələrin sayı qiymətləndirilməlidir. Qeydiyyat üzrə əməletməni ölçmək üçün potensial vergi ödəyicilərinin ümumi sayı bilinməlidir. Hesabatın dəqiqliyini isə üçüncü tərəf mənbələri, audit yoxlamaları və ya statistik modellər olmadan ümumiyyətlə ölçmək qeyri-mümkündür. Ödəniş üzrə əməletmənin səviyyəsi isə qanunla müəyyən edilmiş son ödəniş tarixindən, eləcə də hissə-hissə ödəniş planlarının, məhkəmə mübahisələrinin, müflisləşmə hallarının və sonradan yığılan borcların hesablama metodologiyasından asılıdır.
Praktikada bu dörd anlayış tez-tez bir-birinə qarışdırılır və onları bir-birindən ayrı saxlamaq təhlil prosesinin ən çətin mərhələlərindən biridir.
Öhdəlik nəticəsi göstəriciləri inzibati dərəcələrdir: vaxtında təqdimetmə və vaxtında ödəniş. Onlar müəyyən bir zaman çərçivəsində konkret bir öhdəliyə qarşı sərgilənən davranışı ölçür.
Vergi mənəviyyatı daha çox münasibəti əks etdirən bir anlayışdır. Luttmer və Singhal bu termin vasitəsilə vergi ödəmənin maliyyə xarakteri daşımayan motivasiya mənbələrini təsvir edirlər: daxili motivasiya, qarşılıqlı fayda, ətraf mühitin təsiri, mədəniyyət və sadəcə olaraq məlumatsızlıq. "World Values Survey" və "European Values Study" kimi sorğuların sualları bu münasibətləri proksi dəyişən kimi istifadə edərək ölkələrarası tədqiqatlar aparmağa imkan verir. Lakin unutmamaq lazımdır ki, münasibəti ölçən sorğu sualı heç bir halda real vergi bəyannaməsini əvəz edə bilməz.
Vergi boşluğu pul ekvivalentində ifadə olunan əks-faktiki (counterfactual) kəmiyyətdir: o, ideal qanunvericilik şəraitində toplanmalı olan məbləğlə faktiki olaraq yığılan və ya bəyan edilən məbləğ arasındakı fərqi göstərir. Bundan əlavə, BVF-nin RA-GAP metodologiyası əməletmə boşluğunu mövcud vergi sisteminin standart etalonlardan kənara çıxması nəticəsində yaranan siyasət boşluğundan fərqləndirir. Yəni, vergi boşluğu heç də hər zaman qəsdən vergidən yayınma demək deyil. Bu anlayış özündə bəyannamə təqdim etməmə, uçot səhvləri və ödəməmə hallarını da birləşdirir; onun həcmi isə potensial vergi bazası ilə bağlı irəli sürülən fərziyyələrdən birbaşa asılıdır.
Məcburi və könüllü bölgülər vergi daxilolmalarını zaman çərçivəsinə və ya vergi idarəsinin müdaxilə statusuna görə təsnif edir. IRS-in tətbiq etdiyi könüllü əməletmə səviyyəsi məhz bu qəbildəndir: o, vaxtında və könüllü həyata keçirilən ödənişlərin qiymətləndirilmiş həqiqi vergi öhdəliyinə nisbətini ifadə edir. Eyni zamanda, TAX-I kimi psixoloji alətlər oxşar terminologiyadan istifadə etsə də, tamamilə fərqli bir ölçünü - bəyan edilmiş könüllü və məcburi motivasiyanı qiymətləndirir. Adlar eyni səslənsə də, ölçülən mahiyyətlər fərqlidir.
Burada qırıq xətlərlə göstərilən oxlar ən çox diqqətdən qaçan məqamdır. İnzibati arxitektura yalnız vergi ödəyicisinin davranışını deyil, həm də vergi orqanının müşahidə imkanlarını dəyişdirir. Məsələn, elektron qaimə-faktura tələbinin tətbiqi əvvəllər sistemdən kənarda qalan və bəyan edilməyən dövriyyəni görünən edir; nəticədə, ödəyicilərin davranışı reallıqda yaxşılaşsa belə, riyazi olaraq ölçülən vergi boşluğu arta bilər. Bu səbəbdən, müşahidə edilən kəmiyyətlərdəki hər hansı dəyişikliyi birbaşa daxili davranışdakı dəyişiklik kimi yozan hər bir təhlil ilk növbədə bu ehtimalı istisna etməlidir.
Ölçmə yanaşmaları bir-birini əvəz etmir
| Ölçmə yanaşması | Əsas kəmiyyət | Əsas verilən tələbi | Səciyyəvi uğursuzluq | Ölkələrarası müqayisə |
|---|---|---|---|---|
| Vaxtında təqdimetmə/ödəniş göstəricisi | Son tarixədək yerinə yetirilmiş gözlənilən öhdəliklərin payı | Reyestr, təqdimetmə təqvimi, ödəniş kitabı | Baza "gözlənilən" öhdəliyin və "aktiv" ödəyicinin necə müəyyən edilməsindən asılıdır | Metaverilənlər harmonizasiyasından sonra orta |
| Yuxarıdan aşağı ƏDV boşluğu | Potensial ƏDV öhdəliyi mənfi faktiki ƏDV gəliri | Milli hesablar, təchizat-istifadə verilənləri, qanuni qaydalar, daxilolmalar | Milli hesablaşma xətaları, zaman fərqləri, güzəşt və dərəcə uyğunlaşdırması, gizli iqtisadiyyat fərziyyələri - bunların hamısı qalıqda əks olunur | Bir metodologiya daxilində orta, müstəqil seriyalar arasında zəif |
| Aşağıdan yuxarı təsadüfi audit boşluğu | Auditdən keçmiş seçmə əsasında əhali üzrə az bəyanetmə | Ehtimal seçməsi, ətraflı yoxlama, seçmə çəkiləri | Aşkarlanmamış yayınma, bəyannamə verməyənlər və gizli fəaliyyət üçün açıq düzəlişlər tələb olunur | Dizaynlar harmonizə olunsa yüksək ola bilər, nadir hallarda olunur |
| Riskə görə seçilmiş audit boşluğu | Əməliyyat auditlərindən ekstrapolyasiya edilmiş əməletməmə | Riskə görə seçilmiş auditlər və seçmə modeli | Verifikasiya yanlılığı: auditdən keçənlər qəsdən təsadüfi seçilməyib | İnandırıcı seçmə düzəlişi olmadan aşağı |
| Vergi mənəviyyatı sorğusu | Münasibət, norma və ya bəyan edilmiş ödəmə istəyi | Harmonizə olunmuş suallarla təmsilçi sorğu | Sosial arzuolunanlıq, tərcümə və mədəni qeyri-invariantlıq, davranışla zəif əlaqə | Harmonizə olunmuş alətlər üçün orta, ad hoc sorğular üçün aşağı |
| Könüllü/məcburi mühasibat bölgüsü | Müəyyən müdaxilə olmadan, müəyyən nöqtəyədək ödənilmiş həqiqi öhdəlik payı | Qiymətləndirilmiş həqiqi öhdəlik, ödənişlər, məcburetmə qeydləri | "Könüllü", "vaxtında" və məcburetmə pəncərəsi sistemdən sistemə dəyişir | Tərif və pəncərələr eyni olmasa aşağı |
| TAX-I tipli alətlər | Latent könüllü və məcburi əməletmə niyyətləri | Validasiya olunmuş sorğu sualları | Niyyəti ölçür, gerçəkləşmiş vergi davranışını yox | Ölçmə invariantlığı yoxlanılarsa orta |
Yuxarıdan aşağı (top-down) və aşağıdan yuxarı (bottom-up) boşluq qiymətləndirmələrinin bir-biri ilə üst-üstə düşməməsi tamamilə təbiidir, çünki bu metodlar tamamilə fərqli statistik obyektlərə əsaslanır. Yuxarıdan aşağı ƏDV qiymətləndirməsi makroiqtisadi xərc və ya əlavə dəyər aqreqatlarına əsaslanaraq potensial vergi öhdəliyini bərpa edir və onu qanunvericilikdəki dərəcə və güzəştlərə uyğunlaşdırır; yerdə qalan fərq (qalıq) isə nəinki faktiki vergidən yayınmanı, həm də milli hesablaşma xətalarını, dövrlərarası zaman fərqlərini, modelləşdirmə xətalarını və iqtisadi-hüquqi təsnifat uyğunsuzluqlarını özündə cəmləşdirir. BVF metodologiyası yuxarıdan aşağı yanaşmaların potensial bazanı formalaşdırmaq üçün bilərəkdən vergi bəyannamələrindən kənar məlumatlardan istifadə etdiyini vurğulayır. Bu isə həmin metodun həm fərqləndirici xüsusiyyəti, həm də ən böyük zəifliyidir.
Bunun əksinə olaraq, aşağıdan yuxarı yönəlmiş təsadüfi yoxlama qiymətləndiricisi birbaşa seçilmiş vergi ödəyicilərinin məlumatlarına əsaslanır. Ən sadə formada bu yanaşma belə ifadə olunur:
burada bəyannamə təqdim etməyənləri, isə audit yoxlamalarının aşkarlaya bilmədiyi ehtimal olunan yayınmaları ifadə edir. Əgər yoxlama həqiqi vergi öhdəliyini üzə çıxara bilirsə, ehtimal əsaslı seçmə (probability sampling) şəraitində birinci komponent dizayn baxımından tamamilə tutarlıdır. Əsl çətinlik isə son iki həddin qiymətləndirilməsində yaranır; belə ki, BVF-nin təlimatları aşkarlanmayan yayınmalar, ödənilməyən vergilər və bəyannamə təqdim etməyən qrupa daxil olan fəaliyyətlər üzrə düzəlişlərin sadəcə tövsiyə xarakterli deyil, məcburi olduğunu vurğulayır. Risk əsaslı seçilmiş əməliyyat yoxlamaları vəziyyəti daha da qəlizləşdirir, çünki bu yoxlamalara cəlb edilən ödəyicilər məhz əvvəlcədən ehtimal olunan vergi yayınmalarına görə hədəfə alınmışdır.
IRS-in Milli Tədqiqat Proqramı (NRP) məhz bu cür problemlərin qarşısını almaq üçün yaradılıb: bu proqram çərçivəsində seçmə metodu hədəfli şəkildə seçilmiş spesifik alt qrupu deyil, bəyannamə təqdim edənlərin ümumi kütləsini təmsil edir. Eyni zamanda, Böyük Britaniyanın HMRC (Kralın Gəlirlər və Gömrük İdarəsi) qurumu da boşluq hesablama sisteminin müəyyən komponentləri üçün təsadüfi audit məlumatlarını həm müxtəlif sorğular, həm də inzibati verilənlərlə paralel şəkildə tətbiq edir. Hər iki yanaşma reallıqdakı məhdudiyyətləri aydın şəkildə nümayiş etdirir: miqyaslı və təsadüfi yoxlamalar olduqca böyük xərclər tələb edir və sistemin bəzi tərkib hissələri hətta bu halda belə statistik modelləşdirməyə möhtac qalır.
Dərc edilmiş qeyri-müəyyənliyin özü də bir veriləndir
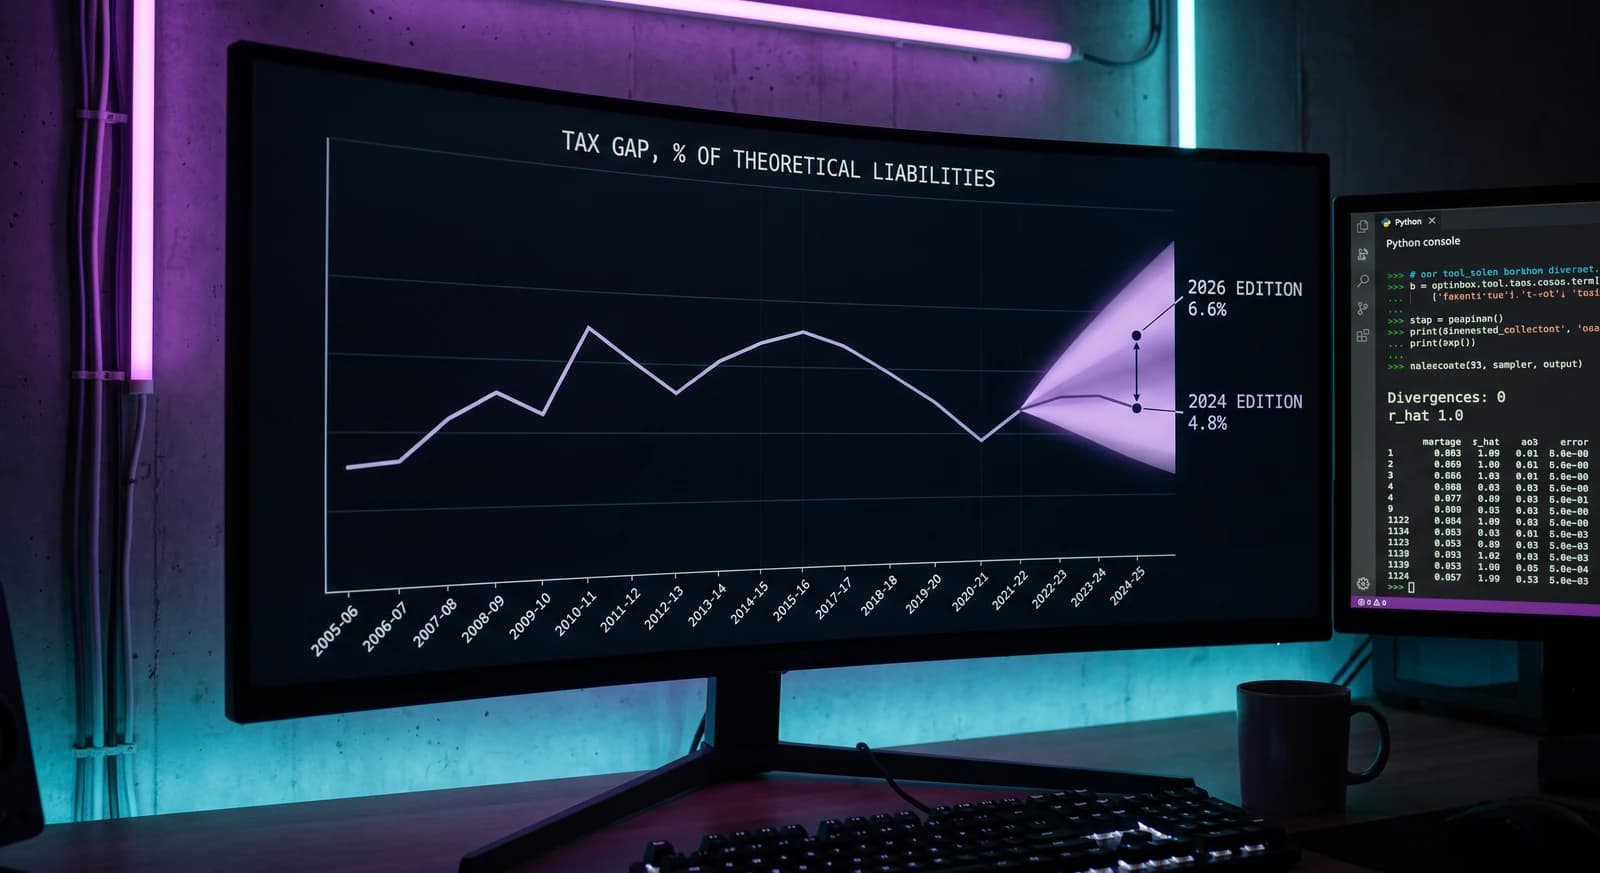
HMRC-nin 2026-cı il buraxılışı aqreqat boşluğun 35 faizinin "yüksək", əlavə 14 faizinin isə "çox yüksək" qeyri-müəyyənliyə malik komponentlərə əsaslandığını təsnif edir. Əvvəlki buraxılışda bu "yüksək" pay cəmi 8 faiz civarında idi. Hazırkı qiymətləndirmənin yarısı artıq birbaşa olaraq hesabatı hazırlayanların özlərinin zəif müəyyən edilmiş adlandırdığı komponentlərə söykənir. Bu, HMRC-yə qarşı irəli sürülmüş bir irad deyil, vergi boşluğu rəqəminin sadə mühasibat qalığı olmadığını xatırladan vacib bir detaldır.
Düzəlişlər bu fikri daha da kəskinləşdirir. Eyni seriyanın ardıcıl üç nəşrindən çıxarılan fərqlərə diqqət yetirək:
| Vergi ili | İlk dərc olunanda | 2026 buraxılışı | Fərq |
|---|---|---|---|
| 2021-22 | 4,8%, sonra 5,2%-ə yenilənib | 6,0% | Yenilənmiş rəqəmə görə +1,2 f.b. |
| 2022-23 | 4,8% (39,8 mlrd £, 2024 buraxılışı) | 6,6% | +1,8 f.b. |
| 2023-24 | 5,3% (46,8 mlrd £, 2025 buraxılışı) | 6,0% | +0,7 f.b. |
| 2024-25 | 6,4% (59,2 mlrd £, 2026 buraxılışı) | 6,4% | ilk qiymətləndirmə |
Baxmayaraq ki, vergi ödəyicilərinin davranışında heç bir dəyişiklik olmamışdı, sırf hesablanma metodunun yenilənməsi səbəbindən 2022-2023-cü illər üzrə vergi boşluğu ilkin dəyərinin üçdə birindən çox həcmdə böyüdü. 2024-cü il buraxılışına model tətbiq edib azalan trend aşkarlayan təhlilçi əlindəki verilənlər üzərində heç bir riyazi xəta etməmişdi. O, sadəcə olaraq həmin verilənin reallıqda nəyi ifadə etdiyi barədə yanılmışdı.
Bu amil sadəcə qeyd kimi kənarda qalmamalı, birbaşa ekonometrik modellərin özünə inteqrasiya edilməlidir. Əgər dərc olunmuş boşluq latent boşluq olan -nin küylü qiymətidirsə,
onda -ni tamamilə xətasız kimi qəbul edən istənilən reqressiya modeli ümumi qeyri-müəyyənlik dərəcəsini aşağı salacaq. Əgər küylü boşluq izahedici dəyişəndirsə, klassik ölçmə xətası əmsalı sıfıra doğru zəiflədir. Ölçmə xətası inzibati potensial, gəlir səviyyəsi və ya rəqəmsallaşma ilə korrelyasiyaya malikdirsə - ki bu, reallıqda mütləq belədir - meylin mütləq sıfıra doğru istiqamətlənəcəyinə dair heç bir zəmanət yoxdur. -ni, dərc edilmiş intervalları və ya xüsusi metoda xas xəta parametrlərini əsas modelin daxilinə daşımaq məhz iyerarxik ölçmə modeli ilə nöqtə qiymətləri üzərində qurulan adi cədvəl reqressiyası arasındakı həlledici fərqdir.
Təkrarlana bilən mənbələr və hər biri üçün "açıq" nə deməkdir
Qlobal miqyaslı tədqiqat layihəsi mütləq şəkildə açıq sənədləşməni açıq mikroverilənlərdən ayırmalıdır, çünki bu kiçik fərq nəticənin gələcəkdə müstəqil şəkildə təkrarlana biləcəyini, yoxsa sadəcə sitat mənbəyi kimi qalacağını müəyyən edir.
| Mənbə | Əməletmə tədqiqatındakı rolu | Giriş statusu | Təkrarlanabilənlik |
|---|---|---|---|
| OECD Tax Administration / ISORA cədvəlləri | Təqdimetmə, ödəniş, borc, rəqəmsallaşma, ştat göstəriciləri | Açıq portal və cədvəllər | Ölkələrarası inzibati panellər üçün uyğundur, metaverilən dəyişikliyi və çatışmazlıq şərti ilə |
| TADAT performans hesabatları | Standartlaşdırılmış diaqnostik sübut | Yalnız qiymətləndirilən orqan icazə verdikdə açıq | Dərc olunan hesabatlar təkrarlana bilən girişdir, qiymətləndirmələrin tam çoxluğu açıq verilən toplusu deyil |
| HMRC Measuring tax gaps | Ətraflı yuxarıdan aşağı və aşağıdan yuxarı seriyalar, metodologiya ilə | Açıq şəkildə yüklənən onlayn cədvəllər | Məhz komponentləri yeniləndiyi üçün buraxılışa həssas iş üçün yaxşıdır |
| IRS vergi boşluğu seriyası | Ümumi və xalis boşluq, könüllü əməletmə dərəcəsi | Aqreqatlar açıq, NRP mikroverilənləri məhdud | Aqreqat replikasiya mümkündür, mikro qiymətləndirmənin müstəqil təkrarı yox |
| UNU-WIDER Government Revenue Dataset | Gəlir strukturu və makro-fiskal nəzarət dəyişənləri | Açıq və pulsuz | Təkrarlana bilən makro panellər üçün tam uyğundur |
| World Values Survey | Vergi mənəviyyatı və institusional münasibət proksiləri | Pulsuz qeydiyyatdan sonra qeyri-kommersiya istifadəsi üçün pulsuz | Lisenziya və versiya nəzarəti şərti ilə təkrarlana bilən |
| European Values Study | Harmonizə olunmuş dəyər və münasibətlər | Açıq, adətən GESIS vasitəsilə | Verilən toplusunun DOI və versiyası qeyd edilməklə təkrarlana bilən |
| Afrobarometer | Afrika üzrə etimad, legitimlik və vergi münasibətləri | Pulsuz istifadə və yükləmə | Münasibətlər üçün faydalı, öhdəlik ölçüsü kimi heç vaxt |
| Latinobarómetro | Latın Amerikasında uzunmüddətli ictimai rəy | Açıq verilən və sənədləşmə yükləməsi | Harmonizə olunmuş dalğalar regional panelləri dəstəkləyir, lisenziya replikasiya materialı ilə arxivlənməlidir |
| World Bank Enterprise Surveys | Firma xüsusiyyətləri və inzibati yük | Qeydiyyat və giriş sazişindən sonra mikroverilənlər | Qeydiyyatlı istifadəçilər üçün replikasiya oluna bilən, məxfilik şərtləri ilə |
ISORA cədvəlləri 2020-ci ilin sentyabrı ilə 2024-cü ilin sentyabrı arasında təşkil edilmiş beş raunddan ən azı birini tamamlayan 175-dən çox yurisdiksiya üzrə qlobal göstəriciləri özündə saxlayır. Lakin geniş coğrafi əhatə ölçmə ekvivalentliyinə zəmanət vermir. Ölkələrarası müqayisələr yalnız və yalnız məxrəclər, vergi növləri, maliyyə illəri, təqdimetmə rejimləri və metodoloji qırılmalar hərtərəfli yoxlandıqdan sonra müdafiə edilə bilər; belə bir yoxlama aparılmadan yığılan panel verilənlər əslində vergi idarəçiliyi haqqında deyil, sadəcə olaraq ölkələrin fərqli təriflərindən doğan əmsallar təqdim edəcək.
Ödəyicilər niyə əməl edir və müdaxilələr əslində nəyi dəyişir
Kanonik məcburetmə modeli mexanizmi izah etmək üçün hələ də ən düzgün başlanğıc nöqtəsidir. Vergi ödəyicisi qeyri-müəyyənlik mühitində nə qədər bəyan edəcəyini seçir və gəliri gizlətməkdən əldə edəcəyi qazancı onun aşkarlanma ehtimalı və yaranacaq cəzalarla müqayisə edir. Allingham və Sandmo bu çərçivəni 1972-ci ildə rəsmiləşdirdilər; Yitzhaki isə cərimənin gizlədilmiş gəlirə deyil, bilavasitə yayındırılmış vergiyə tətbiq edilməsinin vergi dərəcəsinə nəzərən müqayisəli statikanı necə tərsinə çevirdiyini sübut etdi. Bu nəzəriyyə məcburetmə ehtimalının niyə həlledici əhəmiyyət kəsb etdiyini çox gözəl izah edir. Lakin o, vergidən yayınmanın texniki olaraq harada mümkün olduğu barədə demək olar ki, heç nə demir və gözlənilən cəza sıfıra yaxınlaşdığı hallarda insanların niyə hələ də vergi ödədiyini əsaslandıra bilmir.
İnformasiya arxitekturası bu mənzərəni tamamlayan ən güclü empirik əlavədir. Kleven və həmmüəllifləri Danimarkada 40 mindən çox fərdi gəlir vergisi ödəyicisindən ibarət təbəqələşdirilmiş, təmsilçi seçmə üzərində yoxlama apararaq tapdılar ki, üçüncü tərəf hesabatlılığına cəlb edilmiş gəlirlər üzrə yayınma dərəcəsi cəmi 0,3 faiz olduğu halda, özü bəyan edilən gəlirlər üzrə bu göstərici 37 faizə çatır. Həmin sistemdə gəlirin 95 faizi üçüncü tərəflər tərəfindən bəyan edildiyinə görə, ümumi yayınma dərəcəsi olduqca kiçik qalır. Bu tək müqayisə istənilən mürəkkəb davranış parametrindən qat-qat çox şeyi izah edir: əməletmə səviyyəsi yanlış bəyanetmənin texniki baxımdan çətin olduğu yerlərdə yüksək, asan olduğu yerlərdə isə aşağıdır - özü də eyni ölkədə, eyni vergi qanunvericiliyi altında və eyni vətəndaşlar arasında.
Pomeranz eyni mexanizmin böyük firmalar miqyasında da işlədiyini nümayiş etdirdi: 400 mindən çox Çili firması üzərində aparılan iki fərqli təsadüfiləşdirilmiş eksperiment göstərdi ki, ƏDV üzrə sənəd izləri qabaqlayıcı çəkindirmə effekti yaradır və məcburetmə dalğası bütün təchizat zənciri boyu yayılır. Üçüncü tərəf hesabatlılığı sadəcə olaraq vergi ödəyicisinin subyektiv audit ehtimalını artıran alət deyil. O, şəbəkənin hər hansı başqa bir nöqtəsində uyğunsuzluq yaratmadan təqdim edilə biləcək bəyannamələr çoxluğunu riyazi olaraq daraldır.
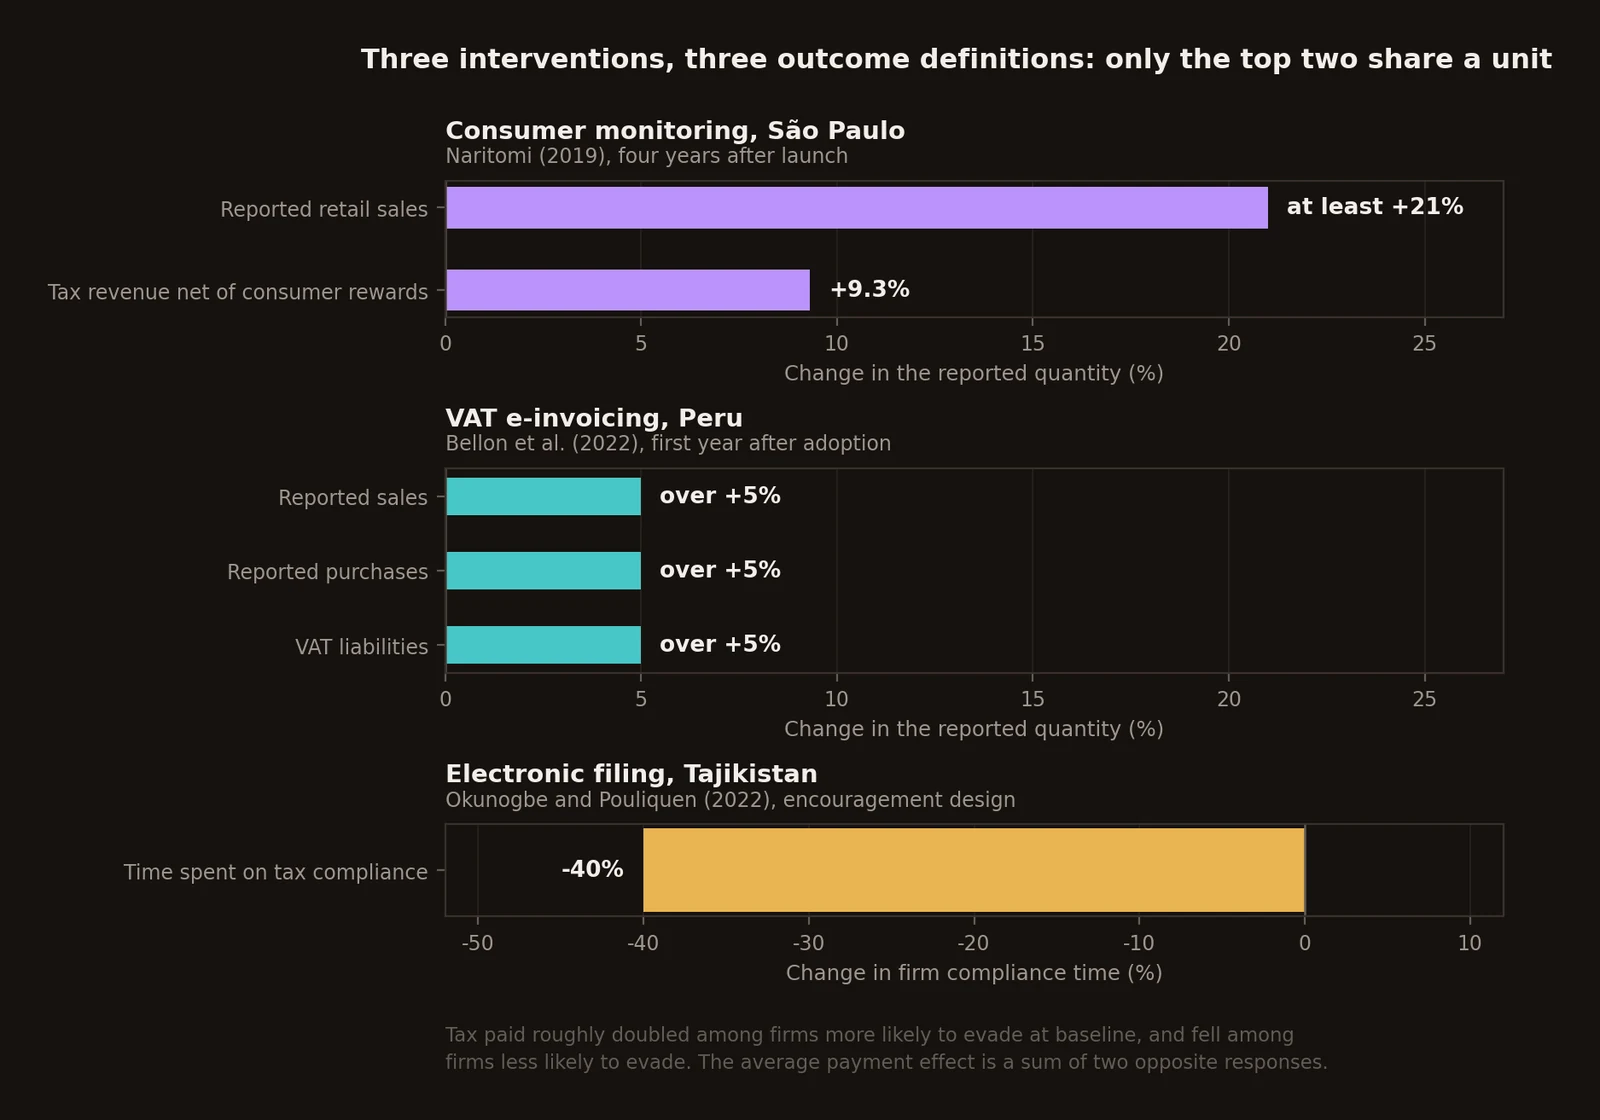
Naritomi bu məntiqi ən son həlqəyə - birbaşa son istehlakçı əməliyyatlarına qədər uzadır; məhz həmin mərhələdə standart ƏDV özünüməcburetmə mexanizmi ən zəif nöqtəsindədir, çünki alıcıya vergi krediti üçün qaimə lazım deyil. San-Pauluda tətbiq edilən istehlakçı mükafatlandırma və məlumatlandırma proqramı dörd il ərzində bəyan edilən pərakəndə satışı ən azı 21 faiz, mükafatlardan sonrakı xalis vergi gəlirini isə 9,3 faiz artırmağa nail oldu. Kommunikasiya eksperimentlərinin əksəriyyətinin sadəcə həftələrlə ölçüldüyü bir ədəbiyyatda dörd illik davamlılıq qeyri-adi dərəcədə məlumatlandırıcı faktdır.
Lakin başqa bir kompensasiya edici marja mövcud olduqda, sadəcə informasiya təminatı kifayət etmir. Carrillo, Pomeranz və Singhal Ekvadorda üçüncü tərəf məlumatları vasitəsilə aşkarlanmış gəlir uyğunsuzluqları barədə xüsusi bildiriş alan firmaları tədqiq etdilər. Firmaların əksəriyyəti buna ümumiyyətlə reaksiya vermədi. Bəyan etdiyi gəliri artıran firmalar isə bunun demək olar ki, hamısını süni şəkildə xərcləri artırmaqla kompensasiya etdilər: hər bir dollarlıq gəlir düzəlişinə 96 sent əlavə xərc yazıldı, nəticədə real olaraq çox az əlavə vergi toplandı. Satışları yoxlayıb, xərc çıxılmalarını tam nəzarətsiz qoymaq yanlış bəyanetmənin qarşısını almır, sadəcə onun yerini dəyişdirir.
Daxili motivasiya reallıqdır, lakin onun xarici validliyini şişirtmək qeyri-mümkündür. Dwenger və həmmüəllifləri Almaniyada bəzi vergi ödəyiciləri üçün tarixən faktiki olaraq heç bir məcburetmə tədbiri olmadan işləyən yerli kilsə vergisini tədqiq etdilər və yenə də ciddi bir əməletmə səviyyəsi müşahidə etdilər. Bu, bütün vergi ödənişlərinin təkcə cəza qorxusu ilə həyata keçirilmədiyini sübut edən ən nadir və təmiz eksperimentlərdən biridir. Kirchler, Hoelzl və Wahlın sürüşkən yamac çərçivəsi bu fərqi çox aydın şəkildə izah edir: məcburi əməletmə hakimiyyətin gücündən, könüllü əməletmə isə qarşılıqlı etimaddan doğur. Bütün bunlar məcburetmədən kənar, alternativ motivlərin mövcudluğunu sübut edir. Lakin bu o demək deyil ki, milli institusional etimadın bir vahid artması birbaşa və daşınabilən (transferable) formada vergi daxilolmalarına səbəb-nəticə təsiri göstərəcək.
Bunu çox açıq şəkildə ifadə etmək lazımdır, çünki iqtisadi ədəbiyyatın ən zəif nöqtəsi məhz buradadır. Etimad və vergi mənəviyyatı arasındakı ölkələrarası korrelyasiyalar həqiqətən mövcuddur və burada tərs səbəbiyyət (reverse causality) anında özünü büruzə verir: proqnozlaşdırıla bilən, effektiv işləyən vergi institutları vətəndaşda etimad yaradır, bu cür etimad edilən institutlar isə öz növbəsində əməletmə səviyyəsini yüksəldə bilir. Sorğu respondentlərinin cavabvermə tərzləri və eyni sualın fərqli mədəniyyətlərdə fərqli cür yozulması məsələni bir az da qəlizləşdirir. Ölkə səviyyəsindəki sabit effektlər zamanla dəyişməyən xüsusiyyətləri udur, ancaq etimad dərəcəsində ekzogen bir dəyişkənlik yarada bilmir.
Sahə müdaxilələri nəyi dəyişir, ölçüldükləri vahidlərdə
Davranışa yönəlik mesajlar üçün ən təmiz kəmiyyət xülasəsi Antinyan və Asatryanın 2025-ci ildə dərc etdikləri meta-analizdə öz əksini tapır. Sadə xatırlatmalar ekstensiv marja üzrə əməletməni təqribən 2,7 faiz bəndi artırır. Vergi mənəviyyatına istinad edən xüsusi məzmun həmin xatırlatmanın üzərinə təqribən 1,4 bənd, birbaşa məcburetmə (cəza) məzmunu isə 3,2 bənd əlavə edir. Nəzarət qrupu ortalarını bildirən alt çoxluqda nəzarət qrupunun təxminən dörddə biri qaydalara onsuz da əməl edənlər idi. Bu isə o deməkdir ki, göstərilən artımlar çox aşağı bir bazadan, özü də əsasən onsuz da borclu olan, ciddi şəkildə seçilmiş spesifik bir kütlə üzərində hesablanıb.
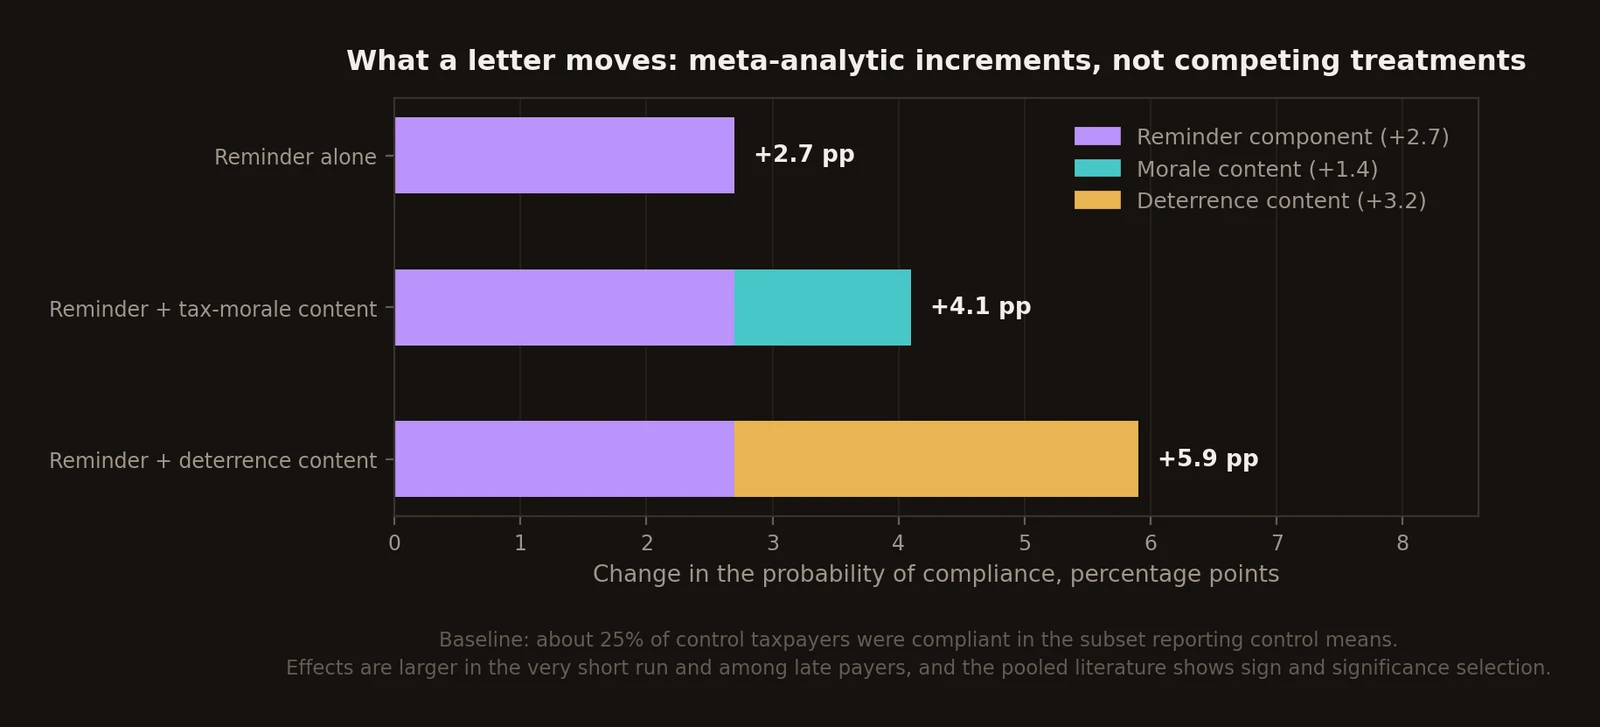
Həmin üç rəqəmi sərbəst, müstəqil nöqtələr kimi qrafikə köçürmək - ki, əksər hallarda seçim və tədqiqat qaralamasının vizual olaraq nəzərdə tutduğu qrafik məhz budur - oxucuya tamamilə yanlış məlumat verir: elə təəssürat yaranır ki, sanki ortada üç fərqli və rəqabət aparan müdaxilə var və ən böyüyü məcburetmədir. Əslində isə, bu üçündən ikisi baza xatırlatmasının üstünə gələn əlavə artımdır və buna görə də yığılmış (stacked) sütun qrafikinə aid edilməlidir. Bu fərq sadəcə qrafik bəzək məsələsi deyil; çünki fərqli məktub şablonları arasında qərar verən idarə məktub göndərib-göndərməməyi yox, göndəriləcək məktubun daxilinə məhz hansı ifadələrin yazılacağını seçir.
Bu ilkin rəqəmlər olduqca ciddi qeyd-şərtlərlə müşayiət olunur. Ən geniş nəşr yanlılığı (publication bias) seçməsi 65 müxtəlif məqalədən 928 fərqli qiymət ehtiva edir və həm huni, həm də reqressiya diaqnostikaları müsbət işarəyə, eləcə də statistik əhəmiyyətliliyə doğru bir seçmə tendensiyası göstərir. Təsadüfi bölgü (randomization) hər hansı bir eksperimentin yalnız daxili validliyini (internal validity) qoruya bilir. Lakin o, dərc olunmuş ədəbiyyatı nəticələrin, spesifikasiyaların, müdaxilə qollarının və bütöv məqalələrin tərəfli seçilməsindən qoruya bilmir. Odur ki, 2,7, 1,4 və 3,2 rəqəmləri mövcud eksperimental mənzərənin sadəcə təsviri xülasəsidir, heç bir halda dəyişməz struktur sabitləri deyil.
Məcburetmə mesajları mütləq şəkildə məcburetmənin özündən fərqləndirilməlidir. Auditdən bəhs edən hər hansı məktub yalnız məcburetmə barədəki inancı və məsələnin aktuallığını (salience) dəyişir; reallıqdakı obyektiv audit ehtimalını isə heç dəyişməyə də bilər. Bergolo və həmmüəllifləri ildə 200 milyon dollardan çox vergi ödəyən 20 440 kiçik və orta firmaya təsadüfi mesajlar göndərdilər və tapdılar ki, yoxlama ehtimalı ilə bağlı verilən məlumat əməletmə davranışını kanonik gözlənilən faydalılıq (expected utility) modelinin təkbaşına izah edə bilməyəcəyi qədər fərqli istiqamətlərdə dəyişir. Əgər bir eksperiment reallıqdakı audit ehtimalını birbaşa təsadüfiləşdirmirsə, "audit hədəsi" adlandırılan eksperimental qol əslində sadəcə qavranılan məcburetməyə edilən müdaxilədir.
Rəqəmsallaşma isə yenə də tamamilə başqa bir kanal vasitəsilə işləyir. Bellon və həmmüəllifləri Peruda mərhələli şəkildə tətbiq edilən ƏDV elektron qaimə islahatını öyrəndilər və tapdılar ki, qəbuldan sonrakı ilk ildə bəyan edilən satışlar, alışlar və ƏDV öhdəlikləri 5 faizdən çox artıb. Üstəlik, bu effekt kiçik firmalarda və əməletməmə riskinin daha yüksək olduğu sektorlarda özünü daha güclü şəkildə göstərmiş, eləcə də ticarət tərəfdaşları üzərindən yayılma effekti (spillover effect) vermişdir - ki bu cür davranış inzibati rahatlıqla yox, birbaşa informasiya şəbəkəsi mexanizmi ilə uzlaşır.
Elektron təqdimetmə sistemləri isə əsasən əməliyyat xərclərini və vergi ödəyicisi ilə dövlət məmuru arasındakı fiziki təması hədəf alır. Okunogbe və Pouliquenin Tacikistanda apardığı təşviq dizaynı firmaların vergiyə sərf etdiyi ümumi vaxtı təxminən 40 faiz aşağı salmağa nail oldu. Ən maraqlı tərəf isə ödəniş effektləri ilə bağlıdır: başlanğıcda vergidən yayınma ehtimalı yüksək olan firmalarda ödənilən vergi təxminən iki dəfə artdığı halda, yayınma ehtimalı aşağı olan firmalarda əksinə azaldı. Tamamilə əks istiqamətli iki reaksiyanı süni şəkildə bir araya gətirən orta effekt heç bir reallığın dəqiq xülasəsi deyil. Ən çox ehtimal olunan mexanizm budur ki, üzbəüz təmasın yoxa çıxması hər iki tərəfdən qeyri-rəsmi "razılaşmaları" pozur, və bu əsla "sadələşdirmə" anlayışının öz mənası deyil.
Əvvəlcədən doldurulmuş (pre-filled) bəyannamələrin effekti isə reallıqda kifayət qədər ikimənalıdır. Əgər üçüncü tərəfdən gələn məlumatlar tam və büs-bütün düzgündürsə, bu sistem katiblik yükünü əhəmiyyətli dərəcədə azaldır. Eyni zamanda o, çox təhlükəli lövbər effekti (anchoring effect) yarada bilər: vergi ödəyicisi belə düşünə bilər ki, əvvəlcədən doldurulmuş bəyannamədə əks olunmayan hər hansı digər məlumat ya əhəmiyyətsizdir, ya da vergi idarəsinə onsuz da məlumdur. Kotakorpi və Laamanenin Finlandiyada apardığı təbii eksperiment göstərdi ki, əvvəlcədən doldurulmayan xərc çıxılmalarında və fərdin özü bəyan etdiyi gəlirlərdə əhəmiyyətli dərəcədə azalma, əvvəlcədən doldurulmuş çıxılmalarda artım müşahidə edilmiş, ümumi vergi tutulan gəlirdə və ödənilən verginin həcmində isə heç bir dəyişiklik olmamışdır. Yəni inzibati rahatlıq və hesabatın dəqiqliyi bir-birinə bərabər məqsədlər deyil.
Əməkdaşlıq əsaslı (cooperative compliance) proqramlar, institusional tətbiqin dəqiq səbəb-nəticə (causal) ölçmələrindən nə qədər qabaqda getdiyini göstərən ən aydın nümunədir. OECD çərçivələri iri bizneslər üçün daha çox şəffaflıq, vergi nəzarəti sistemləri və artırılmış müəyyənlik üzərində qurulmuş xüsusi proqramları təsvir edir. Müşahidə əsaslı tədqiqatlar isə proqramda iştirak, vergi riskinin idarə edilməsi və qavranılan hüquqi müəyyənlik arasında müsbət əlaqələr tapır. Lakin bu məqalənin yazılması üçün nəzərdən keçirilmiş çoxsaylı mənbələrin heç birində, belə proqramların düzgün bəyan edilmiş vergiyə olan səbəb təsirinin daşınabilən (transferable), təsadüfiləşdirilmiş və ya kvazi-eksperimental qiymətləndirməsi mövcud deyil. Bu halda ən dürüst yanaşma sadəcə olaraq "inandırıcı şəkildə identifikasiya olunmayıb" deməkdir, nəinki keyfiyyət iddialarından süni bir rəqəm uydurmaq.
| Müdaxilə | Kütlə və nəticə | Deyilə bilən effekt ölçüsü | Qeyd-şərt |
|---|---|---|---|
| Sadə xatırlatma | RCT ədəbiyyatı üzrə ekstensiv marja | +2,7 faiz bəndi | Çox qısa müddətdə daha böyük; nəşr seçməsi aşkarlanıb |
| Vergi mənəviyyatı mesajı | RCT ədəbiyyatı, xatırlatmaya əlavə | +1,4 faiz bəndi | Heterogen, adətən məcburetmə məzmunundan zəif |
| Məcburetmə mesajı | RCT ədəbiyyatı, xatırlatmaya əlavə | +3,2 faiz bəndi | Məcburetmə aktuallığını ölçür, audit ehtimalını yox |
| İstehlakçı yaratdığı üçüncü tərəf məlumatı | Pərakəndə firmalar, bəyan edilən satış və xalis gəlir | Satış dörd ildə ən azı +21%; mükafatlardan sonrakı gəlir +9,3% | Öyrənilən şəraitdə dörd il davamlı |
| ƏDV elektron qaiməsi | Mərhələli tələb altındakı firmalar | Satış, alış və ƏDV öhdəlikləri birinci ildə +5%-dən çox | Kiçik və yüksək riskli firmalarda daha güclü; şəbəkə yayılması əhəmiyyətlidir |
| Elektron təqdimetmə | Eksperimental təşviqlə e-təqdimetməyə keçən firmalar | Əməletmə vaxtı -40%; ödənilən vergi yüksək bazalı yayınma altqrupunda təxminən ikiqat, aşağı bazalı altqrupda azaldı | Orta effekt iki əks reaksiyanın cəmidir, tək başına sitat gətirilməməlidir |
| Aşkarlanmış uyğunsuzluq bildirişi | Üçüncü tərəf gəlir uyğunsuzluğu olan firmalar | Cavab verənlər hər dollar gəlir düzəlişinə 96 sent xərc əlavə etdi | Kompensasiyaedici marja reaksiyası; yığılan vergi az artdı |
| Faktiki audit | Təsadüfi audit eksperimentləri və sonrakı bəyanetmə | İstiqamət və marja inandırıcı, qlobal müqayisə oluna bilən kəmiyyət yoxdur | Demək olar tamamilə özü bəyan edilən və üçüncü tərəf gəlirindən asılıdır |
| Əvvəlcədən doldurulmuş bəyannamə | Qismən doldurma üzrə təbii eksperiment | Universal müsbət effekt yoxdur; bəzi doldurulmayan maddələr azaldı | Ehtimal olunan lövbər kanalı; ümumi ödənilən vergi dəyişmədi |
| Əməkdaşlıq əsaslı əməletmə | İri biznes proqramları | Səbəb effekti yoxlanılmayıb | Sübut institusional və müşahidə əsaslıdır |
Toplanan empirik sübutlar birölçülü nəzəriyyələri qəti şəkildə rədd edir. Üçüncü tərəf məlumatları və mənbədən vergi tutulmaları vergidən yayınmanı texniki olaraq çətinləşdirir; faktiki və ya qavranılan (perceived) məcburetmə gözlənilən xərci (risk-cost) artırır; xatırlatmalar insan psixologiyasındakı məhdud diqqət problemini həll edir; elektron sistemlər həm hesablama səhvlərini, həm də üzbəüz təmasın gətirdiyi əməliyyat xərclərini azaldır; daxili motivlər isə zəif məcburetmə şəraitində müəyyən dərəcədə əməletməni qoruyub saxlayır. Ancaq bu beş cümlənin empirik əsaslandırılma dərəcəsi bir-birindən çox fərqlidir. İnformasiya hesabatlılığı mexanizmləri və təsadüfiləşdirilmiş kommunikasiya sınaqları qeyri-adi dərəcədə yaxşı identifikasiya olunub. Lakin "etimad əməletmə yaradır" kimi geniş miqyaslı reqressiyalar və sadə əməkdaşlıq proqramı təsvirləri üçün eyni şeyi demək qeyri-mümkündür.
Dörd sual, dörd model
Eyni inzibati verilənlər toplusu ən azı dörd fərqli suala xidmət edir. Əməletmənin həqiqi səviyyəsi nədir? Onun dəyişməsinə nə səbəb olur? Hansı hallar əməletməmə ehtimalı daşıyır? Gələn il aqreqat göstərici nə olacaq? Ölçmə modelləri, səbəb-nəticə dizaynları, risk skorları və proqnozlar bunlara ardıcıllıqla cavab verir və birinin çıxışını digəri ilə əvəz etmək bu sahədə ən yayğın metodoloji səhvdir - yanlış alqoritm seçməkdən xeyli qabaqda.
Ölkələrarası determinantlar
Ümumi spesifikasiya belədir:
burada ilində ölkəsi üçün əməletmə və ya mənəviyyat ölçüsü, ölkə effektləri, isə il effektləridir. Bu kəmiyyət ümumi il şoklarından təmizlənmiş ölkədaxili şərti asılılığı - yəni -dəki dəyişikliklə -dəki dəyişiklik arasındakı əlaqəni ifadə edir. Ölkə səviyyəsindəki sabit effektlər zamandan asılı olmayan fundamental fərqləri aradan qaldırır. Lakin eyni zamanlılıq (simultaneity) problemini həll etmir: çünki institusional etimad, inzibati potensial, rəqəmsallaşma və əməletmə səviyyəsi hamısı birlikdə inkişaf edir. O, asılı dəyişən olan vergi boşluğundakı ölçmə xətasını düzəltmir və sorğu əsaslı mənəviyyat indeksindəki qeyri-invariantlığı aradan qaldırmır. ISORA-nın şəxsi müqayisəli sənədləşməsi belə xəbərdarlıq edir ki, dəyişkən inzibati şərait hətta on illik periodu əhatə edən müqayisələri belə olduqca çətinləşdirir.
Bundan başqa, nəticələr bölməsinə çox nadir hallarda düşən spesifikasiya axtarışı (specification search) problemi də mövcuddur. Əgər siz etimad, korrupsiya, rəqəmsal tətbiqetmə, audit dərəcələri, vergi dərəcələri, bəyannamə xərcləri, gəlir, bərabərsizlik, qeyri-formallıq kimi dəyişənləri və onların bir neçə gecikməsini əvvəlcədən müəyyən edilmiş dəqiq bir hipotez olmadan ardıcıl yoxlasanız, süzgəci mütləq şəkildə elə bir "determinantlar" dəsti istehsal edəcək ki, həmin dəst asılı dəyişənin növbəti buraxılışında artıq sağ qalmayacaq. Requlyarlaşdırma (regularization), iyerarxik priorlar, yanlış aşkarlanma nəzarəti (false discovery control) və kəşfiyyat təhlilinin (exploratory analysis) təsdiqedici təhlildən qəti şəkildə ayrılması bu işin minimumudur. Əgər alət dəyişəni (instrumental variable), kəsilmə nöqtəsi, müdaxilə bölgüsü və ya başqa inandırıcı ekzogen dəyişkənlik mənbəyi yoxdursa, həmin reqressiya sadəcə təsviri (descriptive) xarakter daşıyır və bu söz kənarda deyil, birbaşa xülasədə qeyd olunmalıdır.
İyerarxik Bayes və qismən birləşdirmə nəyə xidmət edir
ölkəsinin seqmentindəki vergi ödəyicisi üçün ehtimal belə yazılır:
burada
Buradakı -dəki indeks əsas işi görür və onu təhlildən kənarda qoymaq çox asandır. O bizə deyir ki, seqment effekti məhz həmin ölkənin içində yerləşir: yəni bir yurisdiksiyadakı mikro müəssisələr başqa bir yurisdiksiyadakı müəssisələr kimi davranmaya bilər. Seqment effektinə bütün yurisdiksiyalar üzrə paylaşılan ortaq beş parametr vermək tamamilə başqa və qat-qat ağır bir fərziyyədir; yazılan işarələmə ilə arxa planda işləyən kodun məhz hansı quruluşu dəstəklədiyi barədə uzlaşması həyati əhəmiyyət daşıyır. Çox vaxt isə onlar uzlaşmır.
Kəmiyyət dedikdə, fərdi və ya seqment səviyyəsindəki əməletmə ehtimalı üzərindəki posterior paylanma və kütlə səviyyəsindəki effektlər nəzərdə tutulur. Qismən birləşdirmə (partial pooling) metodu kiçik və qeyri-sabit xanaların küylü qiymətlərini daha geniş, ümumi paylanmaya doğru sıxır. Bir yurisdiksiyadan yüzlərlə, digərindən minlərlə müşahidə gəldiyi hallarda bunun riyazi əhəmiyyəti olduqca böyükdür. Lakin bu sıxılma müqayisə oluna bilməyən məlumatları mexaniki şəkildə birləşdirmək icazəsi demək deyil: doğruluq funksiyası (likelihood function) hələ də hər bir vahid üçün eyni qaydada tərif edilmiş nəticəyə əsaslanmalıdır və heç bir iyerarxiya ölkədən ölkəyə tamamilə fərqli məna daşıyan təqdimetmə məxrəcini möcüzəvi şəkildə düzəldə bilməz.
Aşağıdakı kod həqiqəti əvvəlcədən məlum olan simulyasiya paneli üzərində icra edilir - mexanizmin həqiqətən də iddia etdiyi işi görüb-görmədiyini yoxlamağın yeganə yolu məhz budur. Verilənləri yaradan proses (DGP): 12 ölkə və 5 seqment, ölkə kəsişmələri , ölkədaxili seqment kənarlaşmaları , əmsalları olan üç standartlaşdırılmış izahedici, qlobal kəsişmə və 45-dən 900-ə qədər dəyişən ölkə seçmə həcmləri - real panel verilənlər qədər balanssız bir quruluş.
import arviz as az
import numpy as np
import pandas as pd
import pymc as pm

df = pd.read_csv("compliance_microdata.csv")

required = {"compliant", "country", "segment", "x1", "x2", "x3"}
missing = required.difference(df.columns)
if missing:
    raise ValueError(f"Missing columns: {sorted(missing)}")
if not set(df["compliant"].dropna().unique()).issubset({0, 1}):
    raise ValueError("'compliant' must be binary.")
df = df.dropna(subset=list(required)).copy()

country_codes, countries = pd.factorize(df["country"], sort=True)
segment_codes, segments = pd.factorize(df["segment"], sort=True)

X_cols = ["x1", "x2", "x3"]
X = df[X_cols].to_numpy(dtype=float)
scale = X.std(axis=0, ddof=0)
scale[scale == 0] = 1.0          # sabit sütun faydasızdır, lakin ölümcül deyil
X = (X - X.mean(axis=0)) / scale

coords = {
    "obs": np.arange(len(df)),
    "country": countries.tolist(),
    "segment": segments.tolist(),
    "feature": X_cols,
}

with pm.Model(coords=coords) as model:
    country_idx = pm.Data("country_idx", country_codes, dims="obs")
    segment_idx = pm.Data("segment_idx", segment_codes, dims="obs")
    X_data = pm.Data("X", X, dims=("obs", "feature"))

    intercept = pm.Normal("intercept", mu=0.0, sigma=1.5)

    # Bütün paylanmalar qeyri-mərkəzləşdirilmiş (non-centered) formadadır.
    # Mərkəzləşdirilmiş forma hər qrupun ortasını birbaşa öz miqyasına bağlayır
    # və nəticədə divergensiya kimi müşahidə olunan huni (funnel) həndəsəsini
    # yaradır - bu da səhv cavabın əldə olunmasından xeyli əvvəl baş verir.
    sigma_country = pm.HalfNormal("sigma_country", sigma=1.0)
    z_country = pm.Normal("z_country", 0.0, 1.0, dims="country")
    country_effect = pm.Deterministic(
        "country_effect", z_country * sigma_country, dims="country"
    )

    # Yuvalanmış (nested) quruluş, gamma_{sc} ilə uzlaşır: qlobal səviyyədə paylaşılan
    # beş fərqli kənarlaşma əvəzinə, hər bir ölkə-seqment xanası üçün bir kənarlaşma.
    sigma_segment = pm.HalfNormal("sigma_segment", sigma=1.0)
    z_segment = pm.Normal("z_segment", 0.0, 1.0, dims=("country", "segment"))
    segment_effect = pm.Deterministic(
        "segment_effect", z_segment * sigma_segment, dims=("country", "segment")
    )

    beta = pm.Normal("beta", mu=0.0, sigma=1.0, dims="feature")

    eta = (
        intercept
        + country_effect[country_idx]
        + segment_effect[country_idx, segment_idx]
        + pm.math.dot(X_data, beta)
    )

    pm.Bernoulli("compliant", logit_p=eta,
                 observed=df["compliant"].to_numpy(), dims="obs")

    idata = pm.sample(draws=1_000, tune=1_000, chains=4, cores=4,
                      target_accept=0.90, random_seed=20260830)

    # extend_inferencedata məcburi addımdır: sample_posterior_predictive təkbaşına
    # yalnız posterior_predictive qrupu olan InferenceData qaytarır, az.plot_ppc isə
    # observed_data qrupunu da tələb edir. Bu olmadan yanlış modeli tutmalı olan
    # yoxlamanın özü qırılır.
    pm.sample_posterior_predictive(
        idata, var_names=["compliant"], random_seed=20260830,
        extend_inferencedata=True,
    )

print(az.summary(
    idata,
    var_names=["intercept", "sigma_country", "sigma_segment", "beta"],
    round_to=3,
))
print("Divergences:", int(idata.sample_stats["diverging"].sum()))
                mean     sd  hdi_3%  hdi_97%  mcse_mean  mcse_sd  ess_bulk  ess_tail  r_hat
intercept      0.662  0.204   0.254    1.041      0.006    0.004  1265.420  1736.140  1.003
sigma_country  0.645  0.201   0.312    1.016      0.006    0.005  1231.296  1636.690  1.001
sigma_segment  0.441  0.073   0.316    0.584      0.002    0.001  1389.388  2425.155  1.001
beta[x1]       0.831  0.040   0.760    0.907      0.001    0.001  6232.936  2920.554  1.001
beta[x2]      -0.399  0.036  -0.463   -0.330      0.000    0.001  6945.731  2792.861  1.003
beta[x3]       0.164  0.034   0.100    0.227      0.000    0.001  6860.902  2595.898  0.999

Divergences: 0

Posterior predictive: observed country filing rate inside the 95% replicated interval for 12 of 12 countries
Mean absolute shrinkage: 0.057 in the smaller half of cells, 0.028 in the larger half
Model verilənləri yaradan həqiqəti bərpa edir: həqiqi 0,85-ə qarşı 0,831; -0,40-a qarşı -0,399; 0,20-yə qarşı 0,164; qrup miqyasları isə 0,55 və 0,35-ə qarşı 0,645 və 0,441 olaraq hesablanıb. R-hat ən çox 1,003, effektiv seçmə həcmləri (ESS) 1 200-dən 6 900-ə qədərdir, heç bir divergensiya yoxdur və müşahidə olunan təqdimetmə göstəricisi on iki ölkənin hamısında 95 faizlik təkrar (replicated) intervalın içinə düşür. İşləyən etibarlı model məhz belə görünür - və meta-analiz bölməsindəki uğursuzluğu məhz bu sağlam fonda oxumaq lazımdır. Bu nöqtəyə çatmaq üçün, diaqnostikalar əmsallardan əvvəl oxunmalıdır: R-hat, effektiv seçmə həcmi və divergensiya sayı posterior paylanmaya ümumiyyətlə baxmağın ilkin şərtidir. Hazırda qəbul edilmiş standart tövsiyə rank-normallaşdırılmış bölünmüş R-hat və ESS-dir; fəza boyu heç vaxt düzgün hərəkət etməmiş qırıq bir zəncirdən çıxan "məqbul görünüşlü" posterior orta əslində heç nəyin sübutu deyil. Bu diaqnostik yoxlamanın hesablama baxımından bahalı olduğu ölçüdə zəncirləri icra etmək və konvergensiya metriklərini insanın rahat izləyə biləcəyi bir yerə ötürmək paylanmış MCMC konveyerləri haqqındakı ayrıca qeydin mövzusudur.
Praktiki bir qeyd, çünki bu bloku uğurla işlədən və ya işlətməyən əsas fərq elə budur. pytensor kitabxanası model qrafikini C dilinə kompilyasiya edir, lakin sistemdə C kompilyatoru quraşdırılmayıbsa, səssizcə qrafiki Python-da hesablamağa keçir. Bu modeldə aparılan ölçmələr göstərir ki, bir qradiyentin hesablanması həmin yolla 119 ms, numba vasitəsilə isə cəmi 0,106 ms çəkir - yəni təxminən 1 120 dəfə fərq. NUTS alqoritmi hər nümunə üçün onlarla qradiyent tələb etdiyinə görə bu səssiz geriyə keçid 36 saniyəlik sürətli icranı zəncir başına bir neçə saatlıq əzaba çevirir. compile_kwargs={"mode": "NUMBA"} parametri heç bir xarici kompilyator tələb etmir və C alətlər zəncirinin mövcudluğu şübhəli olan hər bir sistemdə standart olaraq qeyd edilməyə dəyər.
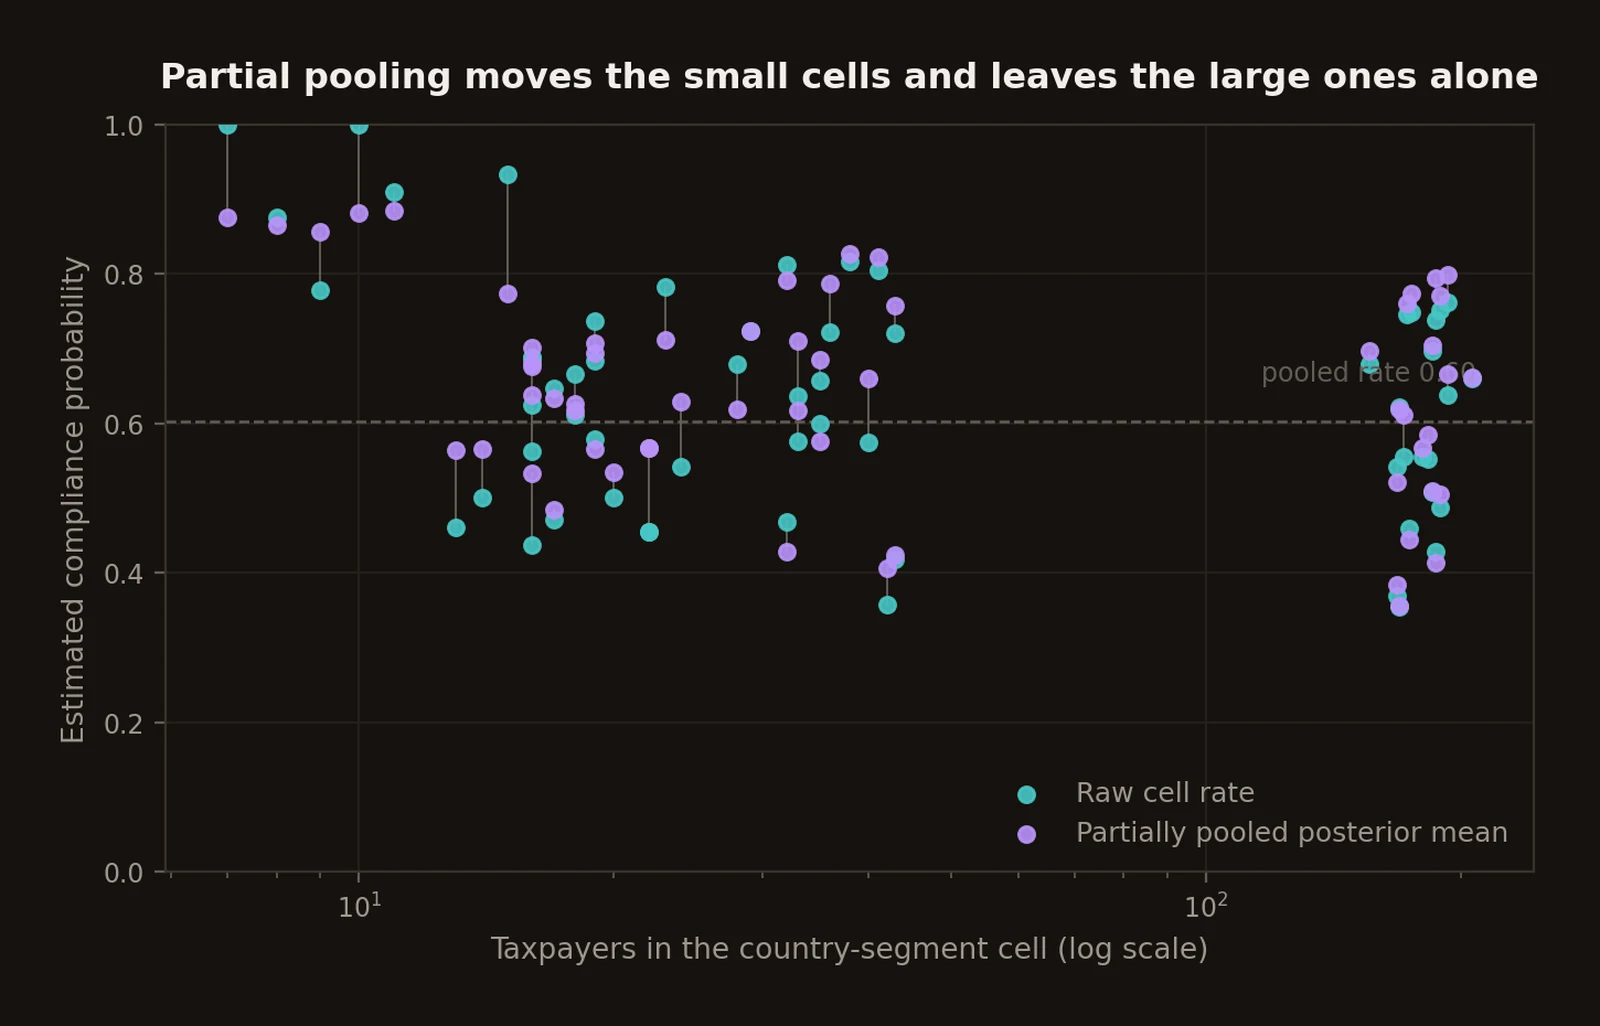
Bu qrafik modelin lehinə olan arqumentin özüdür. Orada müşahidə sayı 7 ödəyicidən 206-ya qədər dəyişən 60 müxtəlif ölkə-seqment xanası var və xam dərəcələr sanki davranışın yox, seçmə həcminin diktə etdiyi kimi davranır: ən kiçik dörddəbirdə xam dərəcə 0,44-dən 1,00-a qədər gedir - altı və on müşahidənin gücü ilə iki xana guya mükəmməl əməletməyə çatır - ən böyük dörddəbirdə isə bu göstərici 0,43 ilə 0,76 arasında rəqs edir. Qismən birləşdirmə kiçik xanaları məntiqi oxa doğru tərpədir, böyükləri isə toxunulmaz qoyur: orta mütləq hərəkət xanaların ən kiçik yarısında 0,057, böyük yarısında isə cəmi 0,028-dir.
Bu, modelin sadəcə verilənin üstündən kobud şəkildə keçməsi deyil. Bu, altı müşahidənin sırf təsadüfən yarada biləcəyi 1,00 dərəcəsinə (100% əməletməyə) inanmaqdan imtina, lakin iki yüz müşahidə üzərində qiymətləndirilmiş dərəcəyə isə demək olar ki, toxunmamaqdır. Yurisdiksiyaları və ya seqmentləri sırf xam dərəcələrə görə sıralayan idarə əslində onları xeyli dərəcədə hər birinin təsadüfən neçə ödəyici saxladığına görə sıralamış olur.
Meta-analiz və dərc olunmuş ədəbiyyatla gələn seçmə
Standart xətası olan müstəqil effekt qiyməti üçün bu model keçərlidir:
burada birləşdirilmiş orta (pooled mean), isə tədqiqatlararası heterogenlikdir. Lakin bundan əvvəl bütün nəticələr vahid bir kəmiyyətə - tərcihən son tarixədək təqdimetmə və ya ödəmə kimi ekstensiv marja hadisəsindəki faiz bəndi dəyişməsinə - keçirilməlidir. Gəlirdəki faiz dəyişmələri, loqarifmik şəkildə bəyan edilmiş gəlir və birbaşa faiz bəndi ilə ölçülən ödəniş reaksiyaları çox aydın bir effekt ölçüsü çevrilməsi olmadan birləşdirilə bilməz; eyni eksperimentin bir neçə müxtəlif qolu isə bir-biri ilə korrelyasiyalıdır, ona görə də onları müstəqil saymaq ümumi qeyri-müəyyənliyi aşağı salır.
Heterogenlik bir maneə deyil, elə tapıntının özüdür. Böyük bir rəqəmi o deməkdir ki, tapılan "orta xatırlatma effekti" növbəti idarə üçün çox az proqnostik məzmun daşıyır - tədqiqatı oxuyan şəxsin bilmək istədiyi ən vacib detal isə məhz budur. Deməli, oxucuya təqdim ediləcək kəmiyyət yalnız ortanın etibarlılıq intervalı deyil, həm də növbəti yeni tədqiqat üçün nəzərdə tutulan proqnoz intervalıdır.
Nəşr yanlılığı (publication bias) diaqnostikalarının hər biri fərqli bir suala cavab verir. Huni asimmetriyası (funnel asymmetry) daha az dəqiq olan qiymətlərin sistematik olaraq daha böyük nəticə verib-vermədiyini soruşur. Egger reqressiyası bunu dəqiqliyə görə reqressiya edilmiş standart normal kənarlaşma kimi rəsmiləşdirir və kəsişmə elə testin özüdür. PET və PEESE effekti isə müvafiq olaraq standart xətaya və seçmə dispersiyasına görə reqressiya edir və kəsişməni sonsuz dəqiqlikdəki (sıfır xətalı) effekt kimi oxuyur. P-əyrisi əhəmiyyətli nəticələrin paylanmasına baxır və ən çox ehtimal olunan astananın bir az altındakı süni yığılmanı üzə çıxara bilir. Bu metodların heç biri nəşr yanlılığını möcüzəvi şəkildə düzəltmir; lakin birlikdə çox güclü bir həssaslıq zərfi (sensitivity envelope) verirlər.
Onları real ədəbiyyat üzərində işlətmək bizə bu zərfi göstərir, lakin onun düzgünlüyünü heç vaxt sübut etmir, çünki həqiqət müşahidə olunmur. Ona görə də aşağıdakı kod seçmə qaydası tam məlum olan sintetik bir ədəbiyyat bazası üzərində işləyir: 140 namizəd tədqiqat, 1,20 faiz bəndlik həqiqi orta effekt, 0,90 tədqiqatlararası heterogenlik və yalnız olanda tədqiqatı mütləq şəkildə, əks halda isə cəmi 0,20 ehtimalla dərc edən bir nəşr süzgəci. 140 tədqiqatdan yalnız 68-i bu süzgəcdən sağ çıxır. Bütün 140 namizəd üzrə real orta effekt 1,086; süzgəcdən keçib dərc olunan 68 məqalə üzrə isə bu göstərici 1,838-dir.
import arviz as az
import numpy as np
import pandas as pd
import pymc as pm
import statsmodels.api as sm
from scipy.stats import norm

df = pd.read_csv("meta_effects.csv")
required = {"effect_pp", "se_pp"}
missing = required.difference(df.columns)
if missing:
    raise ValueError(f"Missing columns: {sorted(missing)}")

df = df.replace([np.inf, -np.inf], np.nan).dropna(subset=list(required))
if (df["se_pp"] <= 0).any():
    raise ValueError("All standard errors must be positive.")

y = df["effect_pp"].to_numpy(float)
se = df["se_pp"].to_numpy(float)
J = len(df)

with pm.Model() as meta_model:
    mu = pm.Normal("mu", mu=0.0, sigma=10.0)
    tau = pm.HalfNormal("tau", sigma=5.0)
    theta = pm.Normal("theta", mu=mu, sigma=tau, shape=J)
    pm.Normal("effect", mu=theta, sigma=se, observed=y)

    idata = pm.sample(draws=3_000, tune=3_000, chains=4, cores=4,
                      target_accept=0.95, random_seed=20260830)

print(az.summary(idata, var_names=["mu", "tau"], round_to=3))

# İdarənin verdiyi sual NÖVBƏTİ sınağın nə edəcəyidir, ona görə əhəmiyyətli
# olan interval ortanın etibarlılıq intervalı yox, proqnoz intervalıdır.
draws_mu = idata.posterior["mu"].values.ravel()
draws_tau = idata.posterior["tau"].values.ravel()
predictive = np.random.default_rng(20260830).normal(draws_mu, draws_tau)

precision = 1.0 / se
snd = y / se

# Egger: dəqiqliyə görə standart normal kənarlaşma. Test kəsişmənin özüdür.
egger = sm.OLS(snd, sm.add_constant(precision)).fit(cov_type="HC3")
# PET: standart xətaya görə effekt, tərs-dispersiya çəkili.
pet = sm.WLS(y, sm.add_constant(se), weights=1.0 / se ** 2).fit(cov_type="HC3")
# PEESE: seçmə dispersiyasına görə effekt, eyni çəkilər.
peese = sm.WLS(y, sm.add_constant(se ** 2), weights=1.0 / se ** 2).fit(cov_type="HC3")

p_two_sided = 2.0 * norm.sf(np.abs(y / se))
p_sig = p_two_sided[p_two_sided < 0.05]
      mean     sd  hdi_3%  hdi_97%  mcse_mean  mcse_sd  ess_bulk  ess_tail  r_hat
mu   1.696  0.126   1.464    1.941      0.001    0.001  8799.684  9526.840    1.0
tau  0.735  0.103   0.544    0.922      0.001    0.001  5075.282  7865.185    1.0

Divergences: 0
Pooled mean            1.696 pp [1.449, 1.945]
Prediction interval    [0.220, 3.202] pp for the next study
True mean in the DGP   1.200 pp

Egger intercept        +1.446 (SE 0.897, p = 0.1071)   non-zero means small studies report larger effects
PET intercept          +0.744 (SE 0.671, p = 0.2672)   effect extrapolated to SE = 0
PEESE intercept        +1.189 (SE 0.392, p = 0.0024)

Published estimates    68
Significant at 5%      55 (80.9%)
Naive published mean   1.838 pp   (+53% against the truth)
Bunu həqiqəti əvvəlcədən məlum olan verilən üzərində işlətməyin ən böyük mənası hər bir rəqəmin yoxlana bilməsidir və üç nəticə heç də oxucunun gözlədiyi kimi çıxmır.
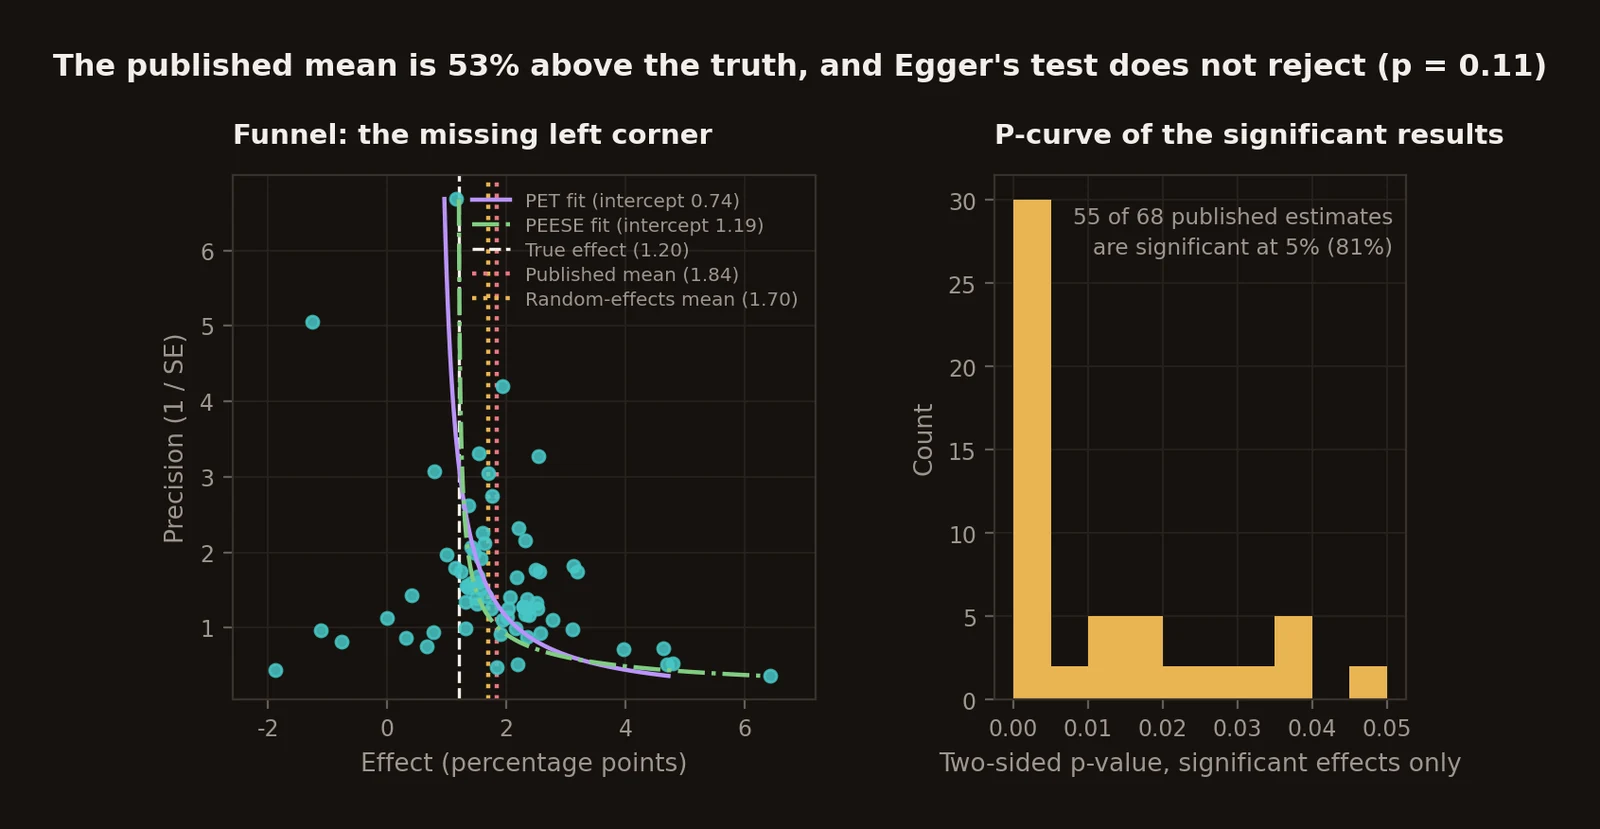
Sadə dərc ortası olan 1,838 əsl həqiqəti düz 53 faiz şişirdir. Lakin Bayes təsadüfi effektlər (random effects) modeli də vəziyyəti xilas etmir. Seçmə xətası və heterogenlik baxımından qüsursuz, lakin nəşr seçməsini (publication bias) heç cür nəzərə almayan birləşdirmə posterior orta olaraq 1,696, 95 faizlik etibarlılıq intervalı olaraq isə [1,449; 1,945] verir - yəni həqiqi 1,20 intervaldan tamamilə kənarda qalır. Bütün konvergensiya diaqnostikaları tərtəmizdir: R-hat 1,0, effektiv seçmə həcmləri minlərlədir, heç bir divergensiya yoxdur. Süzülmüş seçməyə uydurulmuş ən düzgün spesifikasiyalı iyerarxik model belə, sadəcə süzülmüş seçmənin dəqiq və nizamlı qiymətidir.
Daha sonra Egger testi də uğursuz olur. Kəsişmə +1,446, standart xəta 0,897, p = 0,107 - yəni seçmə qaydası birbaşa generatorun içinə öz əlimizlə yazıldığı üçün məlum olan ədəbiyyat üzərində standart huni asimmetriyası testi beş faizlik səviyyədə heç nəyi rədd etmir. 68 tədqiqat əslində çox deyil və huni əsaslı testlər bu cür kiçik ölçülərdə ciddi şəkildə gücsüz qalır. Əhəmiyyətli çıxmayan Egger testi seçmənin olmadığının sübutu deyil, onu təminat kimi oxucuya bildirən məqalə isə sadəcə olaraq testin gücünün olmadığını nümayiş etdirir.
Ardınca PET və PEESE metodları bir-biri ilə dərin ziddiyyətə düşür. Effekti sıfır standart xətaya ekstrapolyasiya edən PET +0,744 və p = 0,267 verir, yəni həqiqətdən qat-qat aşağıda qalır. Bunun əvəzinə birbaşa seçmə dispersiyasına görə reqressiya edən PEESE isə +1,189 verir - həqiqi 1,200 dəyərindən cəmi 0,011 aralı. Şərti PET-PEESE qaydası belədir: əvvəlcə PET-i işlətmək, PET-in kəsişməsi əhəmiyyətli dərəcədə müsbətdirsə PEESE-yə keçmək. Burada isə PET əhəmiyyətli deyil, deməli standart qayda elə orada dayanıb düzəldiləsi effekt olmadığı qənaətinə gəlir və əsl düzgün cavabı verən yeganə qiymətləndiricini kənara atır. Eyni verilənlər üzərində bu qədər fərqlənən iki qiymətləndirici təhlilçiyə göstərir ki, verilən qiymət empirik sübut deyil, sadəcə funksional formanın nəticəsidir.
Bu mənzərədə ən yaxşı işləyən isə mövcud olan ən kobud diaqnostikadır. Dərc olunmuş 68 qiymətdən 55-i, yəni 81 faizi, beş faizlik səviyyədə əhəmiyyətlidir. Tədqiqatlararası heterogenlik 0,9-dur və bu qədər böyük standart xətalarla süzülməmiş heç bir ədəbiyyat belə bir pay vermir - bunu görmək üçün heç bir mürəkkəb test lazım deyil. P-əyrisi açıq-aşkar sağa əyilidir, deməli altda real bir effekt var. Əhəmiyyətlilik payı isə birmənalı olaraq deyir ki, bu məlumatlar nəşrə gedən yolda çox ciddi şəkildə süzülüb.
Antinyan və Asatryanın real ədəbiyyat üzərindəki şəxsi diaqnostikalarını da məhz bu işıqda oxumaq lazımdır. Onlar xatırlatmaların heç bir işə yaramadığını iddia etmir; onların p-əyrisi yuxarıdakı sübutla eyni istiqaməti göstərir. Onlar sadəcə olaraq dərc olunmuş qeydlərin işarə və əhəmiyyətliliyə görə ciddi seçmə daşıdığını göstərirlər. Bu isə 2,7 faiz bəndini məktubun real təsirinin qərəzsiz qiyməti yox, nəyin dərc olunduğunun statistik təsviri edir. Buna veriləcək yanlış reaksiya süni düzəliş əmsalı uydurub vurmaqdır. Ən düzgün reaksiya isə birləşdirilmiş ortanı, proqnoz intervalını və yanlılıq diaqnostikalarının hamısını birlikdə bildirmək, onlardan hansının nəyisə aşkarlamağa riyazi gücünün çatdığını açıq demək və həmin zərfin enini yekun cavab kimi qəbul etməkdir.
İnzibati şəraitdə səbəb-nəticə identifikasiyası
Təsadüfiləşdirilmiş kommunikasiya sınaqları müdaxilə niyyəti (Intention-To-Treat) effektini qiymətləndirir,
bir şərtlə ki, bölgü həqiqətən təsadüfi olsun, iştirakçının itirilməsi və nəticənin ölçülməsi metodologiyası bölgüdən fərqli şəkildə asılı olmasın, yayılma effektləri isə ya ümumiyyətlə olmasın, ya da nəzərdə tutulan kəmiyyətin bir hissəsi kimi nəzərə alınsın. Buradakı ən böyük təhlükə bölgü deyil, məhz müdaxilənin ikimənalılığıdır: audit məktubu vergi ödəyicilərinə məcburetmə barədə danışmağın effektini qiymətləndirir, məcburetmənin özünün real təsirini yox.
İnzibati islahatlar adətən fərdi səviyyədə təsadüfiləşdirilə (randomize edilə) bilmir. Fərqlərin fərqi (Difference-in-Differences) metodu islahat astanasında müdaxilə olunan və olunmayan vahidləri müqayisə edir və identifikasiya fərziyyəsi müşahidə olunan trendlərin paralel görünməsi barədə deyil, məhz müdaxilə olunmayan potensial nəticə trendləri barədədir. Mərhələli qəbul və heterogen effektlərlə işləyən klassik ikitərəfli sabit effektli hadisə tədqiqatı artıq müdaxilə olunmuş və yeni müdaxilə olunan qruplar arasında ciddi şəkildə çirklənmiş müqayisələr qurur; qrup-zaman qiymətləndiriciləri və qarşılıqlı təsir çəkili hadisə tədqiqatları məhz bu uğursuzluğu aradan qaldırır, amma yenə də inandırıcı və müdafiə oluna bilən müqayisə qrupu, eləcə də qabaqlayıcı davranışın olmamasını tələb edir. Sintetik nəzarət böyük bir islahat üçün əgər çəkili donor hovuzu müdaxilədən əvvəlki trayektoriyanı dəqiq bərpa edə bilirsə uyğundur. Yığılma və kəsilmə nöqtəsi dizaynları qeydiyyat və ya dövriyyə astanalarından istifadə edir, lakin yalnız o halda ki, əks-faktiki sıxlıq və ya potensial nəticələr hamar olacaqdı və eyni nöqtədə başqa heç bir qayda dəyişmir.
Reallıqda isə ən çox səssizcə pozulan elə bu son şərtdir. Almunia və López-Rodríguezin İspaniyada həcmdən asılı monitorinq üzrə işi bu astanaların niyə bu qədər məlumatlandırıcı olduğunu göstərir: firmalar iri vergi ödəyicisi həddinin dərhal altında yığılır və yaranmış artıq kütlə rejimə olan reaksiyadır. Lakin bu, həmin xəttdəki bütün qanuni paketə reaksiyadır. Qeydiyyat tələbləri, hesabat tezliyi, audit intensivliyi və vergi öhdəliyi eyni dövriyyə rəqəmində birdən-birə dəyişirsə, heç bir kənar bant genişliyi tənzimləməsi əlavə riyazi struktur olmadan bu təsirləri bir-birindən ayıra bilməz.
Proqnostik risk modelləşdirməsi
Proqnoz ilk növbədə etiketdən (label) başlayır və etiket obyektiv faktdan çox inzibati bir seçimdir. "Əməl etməyən" anlayışı gec təqdimetməni, 30 gündən sonra hələ də ödənilməmiş borcu, hər hansı xırda audit düzəlişini, müəyyən əhəmiyyətlilik həddindən yuxarı düzəlişi, təsdiqlənmiş irimiqyaslı dələduzluğu və ya sadəcə gözlənilən bərpa oluna bilən gəliri bildirə bilər. Bunların hər biri fərqli kütlələri hədəf alan fərqli proqnoz məsələləridir.
"Audit düzəlişi sıfırdan böyükdür" ehtimalı üzərində öyrətmək həm də seçmə etiket yanlılığı (label selection bias) yaradır, çünki əməliyyat auditləri həmişə hədəflidir. Beləliklə, model əməletməmənin sırf auditdən keçmiş ödəyicilər arasındakı paylanmasını öyrənir - yəni əvvəlki seçmə qaydasının formalaşdırdığı kütləni - və qalan bütün iştirakçılar üçün onun buraxdığı səhvlər görünməz olur. IRS-in NRP-si və HMRC-nin təsadüfi sorğuları kimi unikal təsadüfi ölçmə proqramları adətən ictimai statistik hesabatlılıqla əsaslandırılır; lakin onların mütəxəssislər üçün daha dəyərli xüsusiyyəti modelləri öyrətmək və validasiya etmək üçün xeyli daha az seçilmiş (less biased) bir çərçivə təmin etməsidir.
Ayırdetmə (discrimination) və kalibrləmə tamamilə ayrı xüsusiyyətlərdir və sənayedə daim bir-birinə qarışdırılır. ROC-AUC göstəricisi daha yüksək riskli halların daha aşağı risklilərdən reytinq olaraq yuxarı sıralanıb-sıralanmadığını soruşur. Kalibrləmə isə proqnozlaşdırılan 0,20 ehtimalının həqiqətən də müqayisə oluna bilən hallar arasında 20 faizə yaxın faktiki hadisə tezliyinə uyğun gəlib-gəlmədiyini yoxlayır. Bir model mükəmməl sıralayıb çox pis kalibrlənə bilər. Sabit yoxlama gücünü optimallaşdırmaq üçün əməliyyat baxımından ən mənalı kəmiyyət yuxarı decil qaldırıcısıdır (top decile lift):
burada reytinq sıralamasının ən yuxarı decilidir. Burada "sıralamanın" sözünə xüsusi diqqət yetirmək lazımdır. Yuxarı decili proqnozlaşdırılan ehtimalın 90-cı persentilindən yuxarı olan hər şey kimi qəbul etmək, ağac ansamblı (tree ensemble) bərabər dəyərlər verəndə riyazi olaraq eyni çoxluq demək deyil və bu iki fərqli tərif nəticədə bir neçə faiz bəndi fərqlənə bilər. Brier balı (Brier score) isə birbaşa kvadratik ehtimal xətasını ölçür və buna görə sıralamaya reaksiyası qədər kalibrləməyə də sərt reaksiya verir.
Xüsusiyyət atributlaşdırması da eyni riyazi diqqəti tələb edir. Ağac ansamblından əldə edilən çirklilik əsaslı (impurity-based) əhəmiyyət çox bölünmə nöqtəsi olan dəyişənləri haqsız yerə mükafatlandırır və korrelyasiyalı dəyişənlər arasında prediktiv krediti gözlənilməz şəkildə paylayır. Permutasiya əhəmiyyəti (permutation importance) isə daha əməliyyat xarakterli bir sual verir - xüsusiyyətin nəticə ilə olan əlaqəsi qırıldıqda kənar seçmədəki performans nə dərəcədə pisləşir - lakin bu da səbəbiyyət əhəmiyyəti (causal importance) deyil: korrelyasiyalı əvəzedicilər bir-birini asanlıqla maskalayır, ona görə də model bu məlumatı başqa xüsusiyyətdən bərpa edə bildiyi üçün vacib bir xüsusiyyət tamamilə əhəmiyyətsiz görünə bilər.
Aşağıdakı kod test dövrünə xüsusi bir rejim dəyişikliyi yerləşdirilmiş simulyasiya paneli üzərində işləyir: hər birində 900 vergi ödəyicisi olan 24 aylıq dövr və 19-cu dövrdən etibarən üçüncü tərəf uyğunsuzluğu xüsusiyyətinin əmsalı tam yarıya düşür - bu, vergidən yayınma imkanının böyük bir hissəsini aradan qaldıran yeni elektron qaimə tələbini əvəz edir. Deməli, model tamam başqa bir rejimdə öyrədilir, ancaq başqasında skorlanır; bu isə, hər bir istehsalat skorunun (production score) içində olduğu, lakin heç bir akademik qiymətləndirmənin təkrarlamadığı ən acımasız vəziyyətdir.
import numpy as np
import pandas as pd
from sklearn.calibration import CalibratedClassifierCV, calibration_curve
from sklearn.compose import ColumnTransformer
from sklearn.ensemble import RandomForestClassifier
from sklearn.impute import SimpleImputer
from sklearn.inspection import permutation_importance
from sklearn.metrics import (average_precision_score, brier_score_loss,
                             roc_auc_score)
from sklearn.model_selection import TimeSeriesSplit
from sklearn.pipeline import Pipeline
from sklearn.preprocessing import OneHotEncoder

df = pd.read_csv("risk_scoring.csv", parse_dates=["filing_period"])
if "outcome" not in df or "filing_period" not in df:
    raise ValueError("Input requires 'outcome' and 'filing_period'.")

df = df.sort_values("filing_period").dropna(subset=["outcome"]).copy()
if not set(df["outcome"].unique()).issubset({0, 1}):
    raise ValueError("'outcome' must be binary.")

cutoff = df["filing_period"].quantile(0.80)
train = df[df["filing_period"] <= cutoff].copy()
test = df[df["filing_period"] > cutoff].copy()

features = [c for c in df.columns if c not in {"outcome", "filing_period"}]
X_train, y_train = train[features], train["outcome"]
X_test, y_test = test[features], test["outcome"]

numeric = X_train.select_dtypes(include=np.number).columns.tolist()
categorical = [c for c in features if c not in numeric]

preprocess = ColumnTransformer(transformers=[
    ("num", Pipeline([("impute", SimpleImputer(strategy="median"))]), numeric),
    ("cat", Pipeline([
        ("impute", SimpleImputer(strategy="most_frequent")),
        ("onehot", OneHotEncoder(handle_unknown="ignore")),
    ]), categorical),
])

# class_weight parametrindən istifadə edilmir. Çəki verilməsi proqnozlaşdırılan
# hər bir ehtimalı baza dərəcəsindən (base rate) uzaqlaşdırır - lakin kalibrləmə
# addımının daha sonra geri qaytarmalı olduğu kəmiyyət məhz budur. O, sıralamanı
# dəyişdirmir, əksinə kalibrləməni qat-qat çətinləşdirir. Ehtimal kimi oxunmalı
# olan skor hər ikisini birdən daşımamalıdır.
base = Pipeline([
    ("prep", preprocess),
    ("model", RandomForestClassifier(n_estimators=800, min_samples_leaf=20,
                                     random_state=20260830, n_jobs=-1)),
])

# cv=5 standart çarpaz yoxlaması yox, məhz TimeSeriesSplit. Bütün mahiyyəti
# gələcəyi hər zaman kənarda saxlamaq olan dizaynda təsadüfi qatlar bir ödəyicinin
# sonrakı dövrlərinin onun əvvəlki dövrlərinə tətbiq olunan skoru kalibrləməsinə
# icazə verir ki, bu da fundamental xətadır.
model = CalibratedClassifierCV(estimator=base, method="isotonic",
                               cv=TimeSeriesSplit(n_splits=5))
model.fit(X_train, y_train)

p = model.predict_proba(X_test)[:, 1]
roc = roc_auc_score(y_test, p)
pr_auc = average_precision_score(y_test, p)
brier = brier_score_loss(y_test, p)

# Qaldırıcı SIRALAMANIN xüsusiyyətidir, ona görə də yuxarı decil halların ən
# yuxarı 10 faizidir, sabit ehtimaldan yuxarı olan hər şey yox. Ağac ansamblında
# bərabər dəyərlər olanda bu iki təyinat tamamilə fərqli çoxluqlardır.
order = np.argsort(-p, kind="stable")
k = max(1, int(round(0.10 * len(p))))
top = np.zeros(len(p), dtype=bool)
top[order[:k]] = True

base_rate = float(y_test.mean())
lift_10 = float(y_test.to_numpy()[top].mean()) / base_rate

frac_pos, mean_pred = calibration_curve(y_test, p, n_bins=10, strategy="quantile")

perm = permutation_importance(model, X_test, y_test, scoring="neg_brier_score",
                              n_repeats=20, random_state=20260830, n_jobs=-1)
importance = (
    pd.DataFrame({"feature": features,
                  "importance_mean": perm.importances_mean,
                  "importance_sd": perm.importances_std})
    .sort_values("importance_mean", ascending=False)
)
Train 2024-01-01 to 2025-08-01, 18,000 rows
Test  2025-09-01 to 2025-12-01, 3,600 rows

roc_auc          0.6832
pr_auc           0.3197
brier            0.1475   (base-rate-only model: 0.1501)
base rate        0.1839
top-decile rate  0.3750
top_decile_lift  2.0393
worst calibration bin deviates by 0.1859

             feature  importance_mean  importance_sd
              sector          0.00795        0.00122
third_party_mismatch          0.00784        0.00090
       arrears_count          0.00525        0.00071
   prior_late_filing          0.00455        0.00069
   months_registered          0.00396        0.00045
          amendments          0.00098        0.00023
        turnover_log          0.00033        0.00021

Predicted against observed positive rate, by test period:
                   n  observed  predicted
filing_period
2025-09-01     900.0    0.1778     0.2530
2025-10-01     900.0    0.1867     0.2525
2025-11-01     900.0    0.1944     0.2526
2025-12-01     900.0    0.1767     0.2505
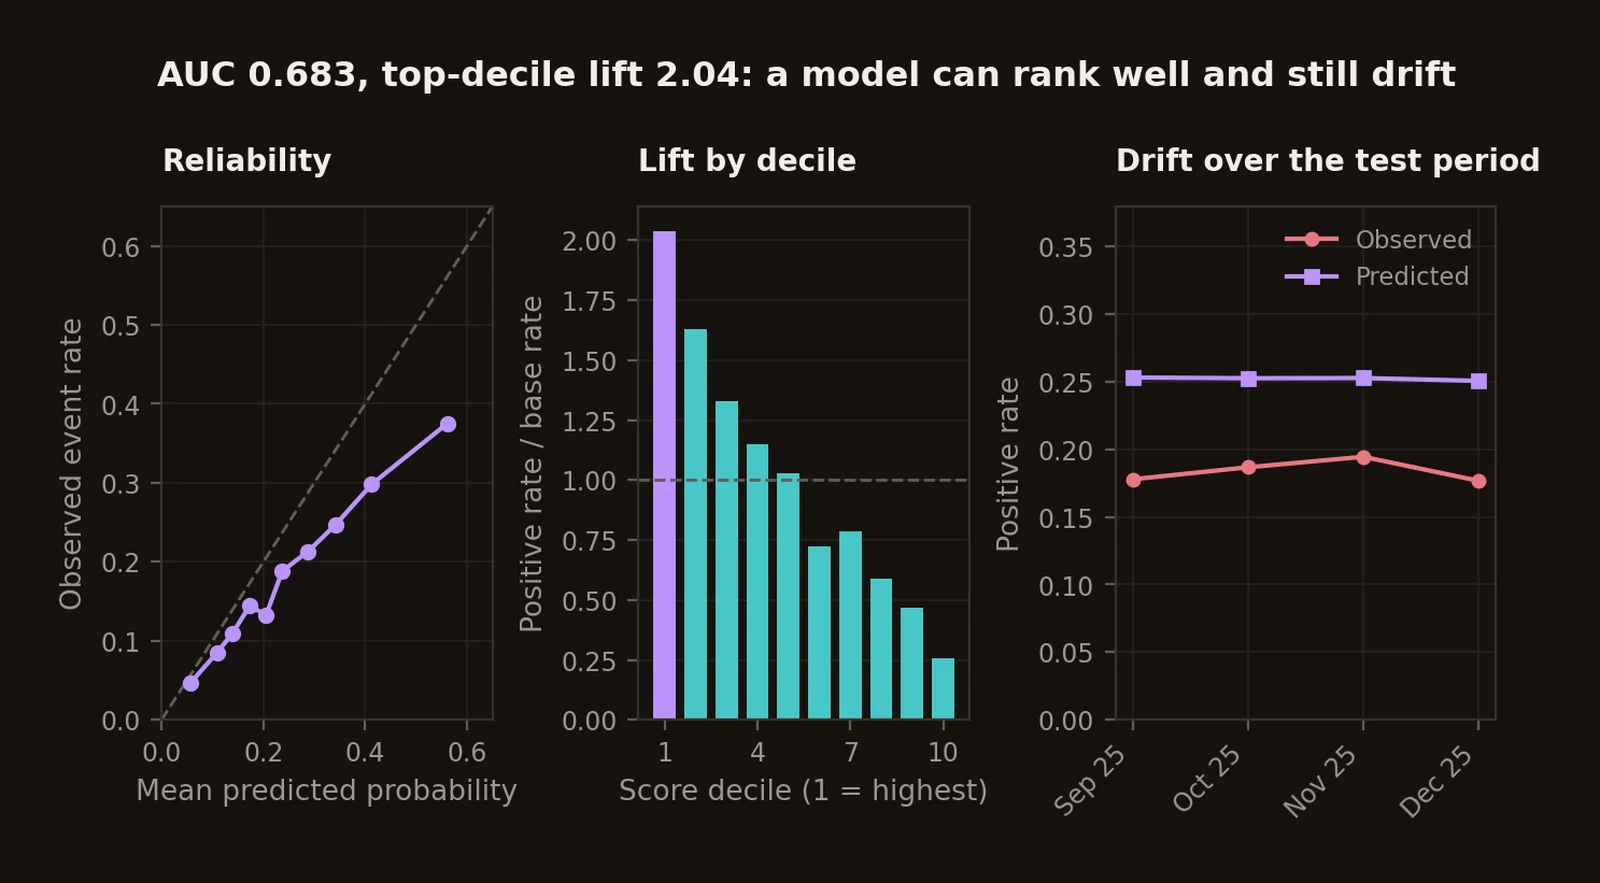
Bu rəqəmləri ardıcıl olaraq bir yerdə oxusaq, yalnız tək bir mənzərə görürük. Sıralama işləyir: yuxarı decil baza dərəcəsinin 2,04 misli qədər müsbət hal saxlayır və decil qaldırıcısı 2,04-dən 0,25-ə qədər monoton şəkildə düşür - audit növbəsinin effektiv qurulması üçün lazım olan məhz budur. Ehtimallar isə ümumiyyətlə işləmir: model hər test ayında təxminən 0,25 proqnozlaşdırır, müşahidə olunan isə reallıqda 0,18-dir; etibarlılıq əyrisi bütün uzunluğu boyu diaqonalın altında qalır və ən pis xana bütöv 0,19 yanılır. Brier balı olan 0,1475 yalnız baza dərəcəsini proqnozlaşdıran ibtidai modelin alacağı 0,1501-i çətinliklə üstələyir. Sıralama dəyəri rejim dəyişikliyindən sağ çıxdı, ehtimal dəyəri isə az qala çıxmırdı. Hər ikisini bildirməyin bütün metodoloji səbəbi budur, modeli yenidən qiymətləndirmək üçün siqnalın AUC yox, məhz kalibrləmə fərqi olmasının səbəbi də budur: ehtimallar hər hansı bir məna daşımağı dayandırandan xeyli sonra da AUC yaxşı görünməyə davam edəcək.
Sinif balanssızlığı, zaman bölgüsündən (time split) və ya kalibrləmə addımından əvvəl artıq seçmə aparmağa qətiyyən haqq vermir. Ən vacib olan şey son skorun gələcəkdə qarşısına çıxacaq qərar kütləsinə oxşayan real bir kütlə üzərində validasiya olunmasıdır və bu, nümunəmizdə olmadı: öyrətmə dövrü 25 faiz, test dövrü isə cəmi 18 faiz müsbət dərəcə ilə işlədi, çünki simulyasiya edilmiş elektron qaimə tələbi modelin aşkarlamağı öyrəndiyi imkanın böyük bir hissəsini reallıqda aradan qaldırdı. Deməli, hər hansı bir sürüşmə monitorinqi (drift monitoring) daim xüsusiyyət paylanması yoxlamalarını, nəticə dərəcəsi yoxlamalarını, sürüşən kalibrləməni və dövri olaraq yenidən qiymətləndirməni mütləq şəkildə tələb edir.
Skor məcburedici bir tədbir yarada bildikdə, onun ədalətlilik (fairness) xarakteri anında dəyişir. Sırf maliyyə gəlirini maksimallaşdırmağa yönəlmiş sıralama müşahidə verilənləri daha zəngin olan qrupları təkrar-təkrar auditə çıxaracaq, məlumatları çətin müşahidə olunanları isə kənarda qoyacaq; nəticədə bu qapalı geri əlaqə (feedback loop) növbəti modelin öyrənəcəyi etiketləri həmişəlik dəyişəcək. Reallıqda müdafiə oluna bilən hər bir istehsalat sistemi mütləq şəkildə model versiyalarının qeydini, dəyişməz xüsusiyyət anlıq şəkillərini (snapshots), sənədləşdirilmiş istisna qaydalarını, altqrup səhv təhlillərini, ciddi cəza tədbirlərindən əvvəl məcburi insan baxışını və ən əsası inzibati verilənlərdəki faktiki səhvlərin düzəldilə biləcəyi əks-əlaqə kanalını tələb edir. OECD-nin son vergi idarəçiliyi tədqiqatları proqnostik analitikanın bu sahədə nə qədər sürətlə yayıldığını sənədləşdirir, bu isə model idarəçiliyini (model governance) nəzəriyyə yox, dövlət səviyyəli kritik bir infrastruktura çevirir.
| Metod | Kəmiyyət | Kritik fərziyyə | Səciyyəvi uğursuzluq | Minimum diaqnostika |
|---|---|---|---|---|
| Yuxarıdan aşağı boşluq modeli | Makro potensial öhdəlik mənfi müşahidə olunan gəlir | Milli hesablar və hüquqi uyğunlaşdırma həqiqi potensial bazaya yaxındır | Qalıq əməletməməni ölçmə və model xətası ilə qarışdırır | Baza, güzəşt, vaxt və verilən yenilənməsinə həssaslıq |
| Təsadüfi audit aşağıdan yuxarı modeli | Əhali üzrə az bəyanetmə | Ehtimal seçməsi və kifayət qədər dəqiq yoxlama | Aşkarlanmayan yayınma və bəyan etməyənlər müşahidə olunan düzəlişdən kənardadır | Dizayn çəkiləri, aşkarlanmama düzəlişi, qeyri-müəyyənlik intervalı |
| Ölkə-il sabit effektli panel | Ölkədaxili şərti asılılıq | Səbəb oxunuşu üçün buraxılmış zamandan asılı qarışdırıcı yoxdur | Etimad, potensial və əməletmə birlikdə müəyyən olunur | Spesifikasiya sabitliyi, klasterlənmiş qeyri-müəyyənlik, çoxluq nəzarəti |
| İyerarxik Bayes | Posterior qrup və fərdi ehtimallar | İyerarxiya şərtində mübadilə oluna bilənlik | Müqayisə olunmayan qrupları birləşdirmək; prior həssaslığı | R-hat, ESS, divergensiyalar, posterior proqnostik yoxlamalar |
| Təsadüfi effektli meta-analiz | Tədqiqat effektlərinin paylanması və ortası | Müqayisə oluna bilən kəmiyyət, modelləşdirilmiş asılılıq | Psevdoreplikasiya, heterogenlik, nəşr seçməsi | , proqnoz intervalı, huni, Egger, PET-PEESE, p-əyrisi |
| RCT | ITT və ya əlavə fərziyyələrlə müdaxilə olunanlar üzrə effekt | Təsadüfi bölgü, etibarlı nəticə ölçməsi, nəzarətli müdaxilələrarası təsir | Müdaxilə məcburetmə yox, aktuallıqdır | Balans, itki, əvvəlcədən müəyyən edilmiş nəticələr, yayılma təhlili |
| DiD və hadisə tədqiqatı | Müdaxilə olunan kohortlar üzrə orta effekt | İnandırıcı müdaxilə olunmayan əks-fakt trendləri | Mərhələli müdaxilə çirklənməsi, qabaqlama | Hadisə vaxtı diaqnostikaları, kohorta xas qiymətləndirici |
| Sintetik nəzarət | Bir və ya bir neçə vahid üzrə effekt | Donor hovuzu əks-faktı bərpa edir | Zəif ilkin uyğunlaşma və ya eyni vaxtda idiosinkratik şok | İlkin uyğunlaşma RMSPE, plasebo və permutasiya təcrübələri |
| Yığılma və RD | Astana ətrafında lokal reaksiya | Astana olmasa əks-fakt hamardır | Eyni nöqtədə bir neçə qayda dəyişir; manipulyasiya | Sıxlıq və bant genişliyi dayanıqlığı |
| Risk klassifikatoru | Əməliyyat etiketinin ehtimalı və ya sıralaması | Etiket mənalıdır və öyrətmə paylanması daşınır | Seçilmiş etiketlər, sızma, sürüşmə, kalibrləmə pozğunluğu | Zaman kənarlaşdırması, Brier, etibarlılıq əyrisi, qaldırıcı, sürüşmə testləri |
Özü qismən proqnozdan ibarət olan seriyanın proqnozlaşdırılması
Vergi əməletməsini proqnozlaşdırmaq inkişaf etmiş makroiqtisadi zaman seriyalarını proqnozlaşdırmaqdan qat-qat çətindir. Bunun səbəbi vergi ödəyicilərinin davranışının daha dəyişkən olması deyil, dərc edilən göstəricilərin illik, qısamüddətli, tez-tez yenilənən və qismən başqa modellərin nəticəsi olmasıdır. Vergi boşluğu seriyasındakı hərəkətlərin bir çox səbəbi ola bilər: bəlkə əməletmə səviyyəsi həqiqətən dəyişib, bəlkə milli hesablar sistemi yenilənib, bəlkə yeni bir audit tədqiqatı fərqli məlumatlar təqdim edib, ya da sadəcə olaraq hesablama metodologiyası dəyişdirilib. Məsələn, IRS-in 2021 və 2022-ci illər üzrə proqnozları böyük ölçüdə 2014-2016-cı vergi illərində yekunlaşmış yoxlamalar əsasında qiymətləndirilən və gələcəyə proyeksiya edilən davranış modellərinə əsaslanırdı. Çox vaxt vergi boşluğu seriyasında müşahidə edilən ən son nöqtə onsuz da öz daxilində ciddi bir proqnoz komponenti saxlayır; yəni, bu məlumatlar üzərində qurulan yeni model əslində başqa bir modelin proqnozunu proqnozlaşdırmağa çalışır.
Vəziyyət fəzası (state space) təsviri buraxılış problemini çox açıq şəkildə nümayiş etdirir:
burada verilən buraxılışını indeksləyir, latent seriya isə belə inkişaf edir:
burada lokal trend, eyni dövrün makro və ya inzibati izahediciləri, isə məlum islahatların işarəsidir. Additiv buraxılış həddi olan bir modelləşdirmə seçimidir, yenilənmələr haqqında qəti bir fakt yox: o iddia edir ki, hər yeni buraxılış bütün seriyanı sabit bir qədər sürüşdürür. Yuxarıda göstərilən HMRC yenilənmələri əslində bu formada deyil - 2022-23 göstəricisi 1,8 bənd hərəkət etdi, 2024-25 isə tamamilə ilk qiymətləndirmədir - ona görə də daha ciddi bir buraxılış modeli mütləq şəkildə komponentə və ya metoda xas hədd tələb edir. Lakin ən sadə versiyanı yazmağa yenə də dəyər, çünki o, dərc olunmuş dəyərlər üzərindəki hər bir reqressiyanın əslində gizli şəkildə qəbul etdiyini görünən edir.
Bundan çox vacib iki nəticə çıxır. Birincisi, backtest (geriyə test) hər zaman sürüşən başlanğıc nöqtələri işlətməli, mümkün olan hər yerdə hər proqnoz yalnız həmin tarixdə faktiki olaraq mövcud olan buraxılışı tətbiq etməlidir; 2019-cu ilin proqnozunu 2026-cı ildə yenilənmiş mükəmməl tarixçəyə qarşı qiymətləndirmək modelin qiymətləndirilməsinə yeddi illik ölçmə yaxşılaşmasını qeyri-qanuni şəkildə sızdırır. İkincisi, nöqtə səhvi heç vaxt kifayət deyil. Ehtimallı proqnoz həmişə interval əhatəsi və kəsilməz sıralı ehtimal balı (CRPS) kimi düzgün bal qaydası ilə qiymətləndirilməlidir, çünki dürüst, lakin geniş intervalla iki bənd yanılan hər hansı proqnoz, öz dəqiqliyi barədə ifrat inamlı intervalla 1,8 bənd yanılandan qat-qat faydalıdır.
Aşağıdakı kod real verilənlər üzərində işləyir: HMRC-nin nəzəri öhdəliklərin faizi kimi hesabladığı ümumi vergi boşluğu, 2005-06-dan 2024-25-ə qədər, 2026 buraxılışının onlayn cədvəllərindən çıxarılmış iyirmi illik tarixi müşahidə.
from math import pi, sqrt

import numpy as np
import pandas as pd
from scipy.stats import norm
from statsmodels.tsa.statespace.structural import UnobservedComponents

MIN_TRAIN, MAX_HORIZON = 10, 3


def normal_crps(observed, mean, sd):
    """Normal proqnoz paylanması üçün CRPS, seriyanın öz vahidlərində."""
    sd = max(float(sd), 1e-12)
    z = (observed - mean) / sd
    return sd * (z * (2 * norm.cdf(z) - 1) + 2 * norm.pdf(z) - 1 / sqrt(pi))


def fit_and_forecast(train, horizon):
    # `level="local linear trend"` model *sətri*dir, model sətri isə qeyri-müntəzəm
    # komponenti onsuz da təyin edir. Tədqiqat qaralaması yanına `irregular=True`
    # ötürürdü; bu əslində SpecificationWarning verməkdən başqa heç nə etmirdi.
    result = UnobservedComponents(train, level="local linear trend").fit(disp=False)
    pred = result.get_forecast(steps=horizon)

    mean = np.asarray(pred.predicted_mean)
    sf = pred.summary_frame(alpha=0.05)
    lower = sf[next(c for c in sf.columns if "lower" in c.lower())].to_numpy()
    upper = sf[next(c for c in sf.columns if "upper" in c.lower())].to_numpy()
    sd = (upper - lower) / (2 * norm.ppf(0.975))
    return mean, lower, upper, sd


series = gap_percentage_series("Total tax gap")     # HMRC onlayn cədvəlləri
y = series["gap_pct"].to_numpy(float)
labels = series["tax_year"].tolist()

records = []
for origin in range(MIN_TRAIN, len(y)):
    H = min(MAX_HORIZON, len(y) - origin)
    mean, lower, upper, sd = fit_and_forecast(y[:origin], H)
    for h in range(1, H + 1):
        actual = y[origin + h - 1]
        records.append({
            "origin": labels[origin - 1],
            "target": labels[origin + h - 1],
            "horizon": h,
            "actual": actual,
            "mean": mean[h - 1],
            "abs_error": abs(actual - mean[h - 1]),
            "covered_95": lower[h - 1] <= actual <= upper[h - 1],
            "crps": normal_crps(actual, mean[h - 1], sd[h - 1]),
        })

bt = pd.DataFrame(records)
report = bt.groupby("horizon").agg(
    mae=("abs_error", "mean"), crps=("crps", "mean"),
    coverage_95=("covered_95", "mean"), n_forecasts=("actual", "size"),
).round(3)

# Qısa illik seriya üçün dürüst ölçü əslində təsadüfi gəzişmədir (random walk): əgər
# struktur model "gələn il elə bu ilə oxşayır" fikrini üstələyə bilmirsə, onda əlavə
# vəziyyətlər sadəcə bəzəkdir.
naive = [{"horizon": h, "abs_error": abs(y[origin + h - 1] - y[origin - 1])}
         for origin in range(MIN_TRAIN, len(y))
         for h in range(1, min(MAX_HORIZON, len(y) - origin) + 1)]
naive_mae = pd.DataFrame(naive).groupby("horizon")["abs_error"].mean().round(3)
HMRC total tax gap, 2005-06 to 2024-25: 20 annual observations
Last two years (2023-24, 2024-25) are HMRC projections, not estimates

Rolling origins: 10, from 2014-15 to 2023-24
           mae   crps  coverage_95  n_forecasts
horizon
1        0.470  0.315        1.000           10
2        0.629  0.456        0.889            9
3        0.899  0.635        0.875            8

Random-walk benchmark MAE by horizon:
horizon
1    0.380
2    0.400
3    0.538

Three-step probabilistic forecast (percentage of theoretical liabilities):
tax_year  mean  lower_95  upper_95
 2025-26 6.347     5.366     7.328
 2026-27 6.360     5.050     7.670
 2027-28 6.373     4.748     7.999
Lokal xətti trend hər üfüqdə sadə təsadüfi gəzişməyə (random walk) uduzur, üstəlik zaman keçdikcə bu fərq daha da genişlənir: bir il irəlidə 0,470-ə qarşı 0,380, üç il irəlidə isə 0,899-a qarşı 0,538. Bu cür neqativ nəticə əslində saxta, "xoşagələn" nəticədən qat-qat daha dəyərlidir. İyirmi illik müşahidə və qiymətləndiriləsi bir səviyyə, bir meyl, eləcə də hər biri üçün bir dispersiya - bütün bunlar uzunmüddətli trendi identifikasiya etmək üçün qətiyyən kifayət deyil, ona görə də modelə uydurulan meyl son bir neçə ilin təsadüfən getdiyi hər hansı istiqaməti tutur və onu əslində geri dönən seriyaya doğru zorla uzadır. Qrafikdəki 2016-17 başlanğıc nöqtəsinə xüsusilə diqqət yetirin: beş illik enmə, inamla davam etdirilən enmə və birbaşa növbəti ildəcə tam əksinə dönən faktiki seriya.
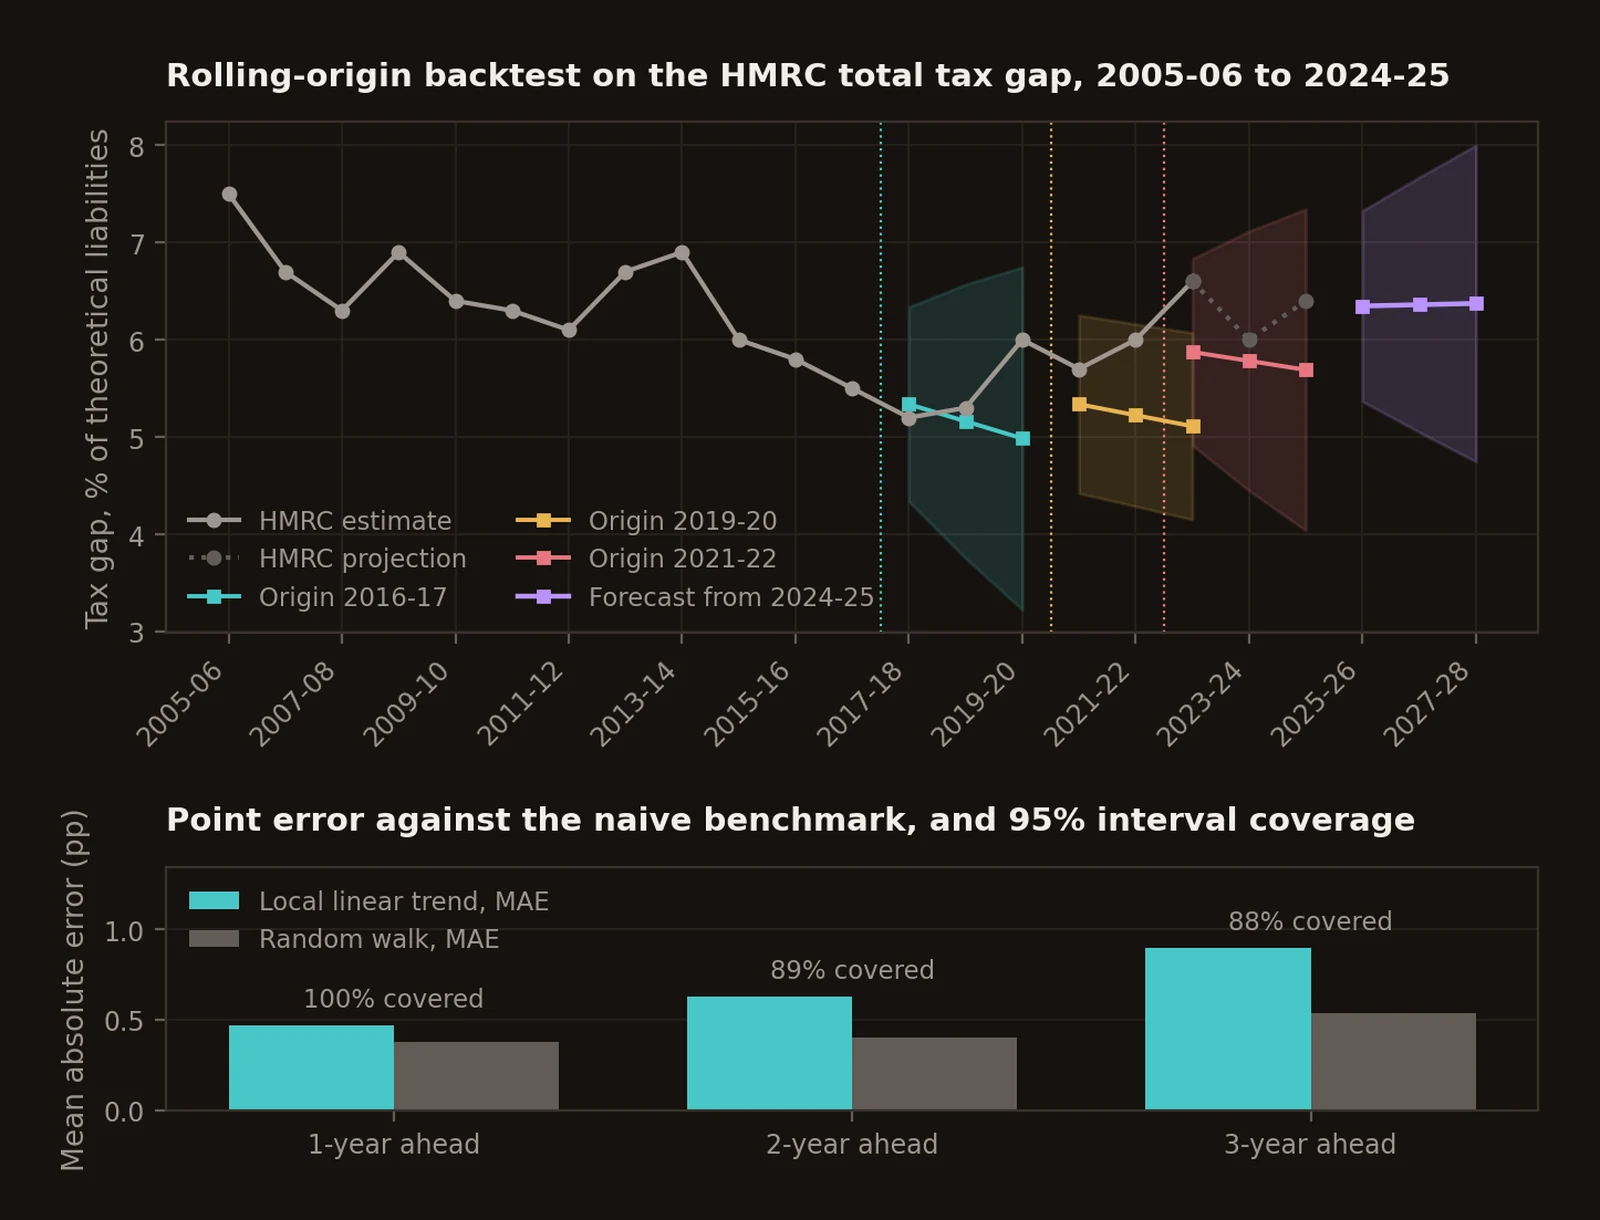
İntervallar isə nöqtə proqnozlarından xeyli daha stabil davranır: nominal 95-ə qarşı 100, 89 və 88 faiz əhatə, yəni modelin mərkəzi trayektoriyası ən sadə variantdan pis olsa da, o, nə qədər az bildiyi barədə heç olmasa dürüstdür. Ehtimallı (probabilistic) qiymətləndirmənin ən güclü praktik arqumenti məhz budur. Orta mütləq səhvə (MAE) əsaslansa, model sadəcə bərbaddır. Əhatəyə görə isə tamamilə işlədilə biləndir və konkret bir rəqəm yox, təhlükəsiz planlaşdırma diapazonu axtaran hər bir idarə ondan müdafiə oluna bilən fundamental nəsə alır.
Bu həm də üfüq (horizon) sualını çox dürüst şəkildə qarşımıza qoyur. Bir-üç illik addım hər zaman müdafiə oluna bilən ən düzgün ilkin seçimdir və bu, empirik sabit deyil, xalis metodoloji mühakimədir. Bir neçə ildən sonra vergi qanunvericiliyi, bəyannamə sistemləri, üçüncü tərəf hesabatlılığı, elektron qaimə, makroiqtisadi tərkib və bütövlükdə ölçmə metodologiyasının özü ilə bağlı olan qeyri-müəyyənliklər lokal trendin sizə verdiyi hər şeyi kölgədə qoyacaq; daha uzun olan hər şey mütləq şəkildə fərz edilən siyasət yolundan asılı ssenari kimi adlandırılmalı və məhz bu cür qiymətləndirilməlidir. Aylıq əməliyyat göstəriciləri - məsələn təqdimetmə və ödəniş dərəcələri - mövsümilik və son tarix effektləri stabil qaldıqca həqiqətən bir neçə aylıq daha yüksək tezlikli proqnozları dəstəkləyir; lakin təqdimetmə sisteminin başqa bir platformaya miqrasiya etdiyi ildə isə o, heç vaxt sabit qalmır.
Etalon arxitektura (Reference architecture)
Sistem dörd təbəqədən ibarətdir və əsl nizam-intizam onların hər hansı birinin daxilində yox, məhz onların arasındakı sərhədlərdədir.
Verilən təbəqəsi (Data layer) hadisə səviyyəsində qeydiyyat, təqdimetmə və ödəniş qeydlərini, üçüncü tərəf hesabatlarını, qaimə şəbəkələrini, audit nəticələrini, kommunikasiya tarixçəsini, vergi ödəyici xüsusiyyətlərini, sorğu verilənlərini və qlobal makroiqtisadi girişləri özündə saxlayır. Hər bir sahə qüvvəyə minmə tarixi və mənşə etiketi daşıyır. Yenilənmiş makro verilənlər və geriyə dönük düzəldilmiş inzibati qeydlər heç vaxt tarixi modelin öyrədildiyi informasiya toplusunun üzərinə səssizcə yazılmamalıdır - bu, proqnoz bölməsinin tələb etdiyi həmin ciddi buraxılış nizamıdır və məhz buna görə də o, modelləşdirmə deyil, birbaşa arxitektur saxlama qərarıdır.
Ölçmə təbəqəsi (Measurement layer) xam hadisələri əvvəlcədən müəyyən edilmiş rəsmi kəmiyyətlərə çevirir: vaxtında təqdimetmə və ödəniş dərəcələri, audit əsaslı yoxlama qiymətləri, yuxarıdan aşağı boşluqlar, sorğu latent dəyişənləri və bütün bunların hər biri üçün qeyri-müəyyənlik paylanması. Məxrəclər (bazalar) və vergi boşluğu üzrə əks-faktlar (counterfactuals) məhz burada tamamilə həll olunur. Əgər onlar birbaşa risk modelinin daxilində həll olunursa, görünməz və versiyasız qaldıqları üçün izlənilməz olurlar.
Çıxarış təbəqəsi (Inference layer) səbəbiyyət (causal) suallarına cavab verir. Təsadüfi kənarlaşdırma (holdout) qrupları məktub və iş axını effektlərini mütəmadi qiymətləndirir - yəni, müdaxilənin həqiqətən də işlədiyinə tam inanılan halda belə, kənarlaşdırma qrupu bazada saxlanılır. İslahatların qiymətləndirilməsi yalnız fərziyyələr inandırıcı olduqda kohortaya həssas DiD, sintetik nəzarət və ya kəsilmə nöqtəsi (RD) dizaynlarından istifadə edir, tələblər ödənmədikdə isə bunu açıq və şəffaf şəkildə hesabatda qeyd edir. İyerarxik modellər həddindən artıq kiçik altqrup ortalarını dəqiq saymadan real heterogenliyi qiymətləndirir. Meta-analiz tapılmış empirik sübutları müxtəlif şəraitlər arasında böyük bir ehtiyatla və mütləq proqnoz intervalı ilə birlikdə daşıyır.
Qərar təbəqəsi (Decision layer) proqnozları, iş sıralamalarını (work queues) və resurs bölgüsünü istehsal edir və hər bir vergi ödəyicisini sadəcə binar bir etiketə sığışdırmaq əvəzinə alt təbəqələrdə formalaşmış qeyri-müəyyənliyi qəbul edir. Proqnozlaşdırılan ehtimal ancaq və ancaq öyrətmə paylanması altında əməliyyat nəticəsi barədə bir sübutdur. O, heç bir halda real əməletməmənin sübutu deyil və nəticə modelləşdirmə komandasından nə qədər uzağa gedirsə, onun obyektiv sübut kimi oxunması riski bir o qədər yüksəlir.
İnsan mühakiməsi isə üç əsas sərhəddə tamamilə əvəzolunmazdır: birincisi, hüquqi mənası olan etiketi (label) sistemə təyin etməkdə, ikincisi, davranışdan yox, sadəcə sistem veriləni səhvindən yarana bilən anomaliyanı doğru yozmaqda və üçüncüsü, yanlış müsbətin (false positive) gətirdiyi xərcin həddindən artıq ciddi olduğu cəzalandırma tədbirinə son icazəni verməkdə. Bu, qətiyyən insanların qərəzsiz olduğu iddiası deyil. Bu, model çıxışlarının mövcud inzibati standartı heç kimə bildirmədən, susaraq yenidən tərif etməsinə imkan vermək əvəzinə, fəaliyyətə cavabdehlik daşıyan insani qərar prosesinə olan həyati ehtiyacın sübutudur. Onu cavabdeh edən əsas audit izi girişin anlıq şəklini, modelin son versiyasını, xüsusiyyət çevrilmələrini (feature transformations), ehtimalı, sıralama həddini, səbəb kodlarını, insan müdaxiləsini, sonrakı iş nəticəsini və vergi ödəyicisinin etdiyi hər hansı bir düzəlişi saxlayır. Təsadüfi və ya kvazi-təsadüfi baxış seçmələri qısa müddətdə israfçı görünsə də sistemdə daimi saxlanmalıdır, çünki yalnız və yalnız özünün təyin etdiyi yüksək skorları auditdən keçirən sistem tədricən kütlənin qalan hissəsi haqqında öyrənməyi dayandırır - ən pisi isə, növbəti ehtimal modeli məhz bu tərəfli nəticələr üzərində yenidən öyrədiləcək.
Nə həll olunmayıb
Daşınabilənlik. Müdaxilə ədəbiyyatı xatırlatmaların, qavranılan məcburetmə aktuallığının, üçüncü tərəf məlumatının və rəqəmsal hesabatlılığın vergi əməletməsini doğrudan da dəyişə bildiyini qəti təsdiqləyəcək qədər zəngindir. Lakin heç vaxt universal müdaxilə parametrləri verəcək qədər zəngin deyil. Effektlər verilən üfüqə, ödəyicinin hazırkı statusuna, çatdırılma metoduna və gəlir kontekstinə görə çox dəyişir; gecikmiş problemli ödəyicilər arasında ölçülmüş 3 bəndlik uğurlu effekt, qətiyyən aktiv ödəyicilərin ümumi kütləsinə birbaşa tətbiq edilə bilməz.
Uzunmüddətli davamlılıq. Kommunikasiya eksperimentlərinin mütləq əksəriyyəti öz nəticələrini müdaxilədən çox qısa bir müddət sonra ölçür və meta-analizlər ən böyük effektləri məhz bu qısa müddətlərdə tapır. Naritominin təqdim etdiyi dörd illik sübut əslində informasiya arxitekturasının uzun müddət davam edə biləcəyini göstərir, lakin istehlakçı hesabatlılığı institutu hər kəsə göndərilən sadə xatırlatma məktubu deyil. Sistemə öyrəşmə (habituation), təkrar müdaxilə effektləri və qərarların zamanlararası yerdəyişməsi anında yaranan reaksiyadan qat-qat zəif şəkildə identifikasiya olunub.
Asanlaşdırma ilə məcburetmə arasındakı sərhəd. Elektron təqdimetmə əməletmənin ümumi xərclərini azaldır və eyni zamanda qeyri-rəsmi təması birdəfəlik aradan qaldırır. Elektron qaimə həm informasiya ötürülməsini sürətləndirib sadələşdirir, həm də eyni anda gizli qalan uyğunsuzluqları görünən edir. Əvvəlcədən doldurma vətəndaşın verilən daxil etmə yükünü azaldır, lakin lövbər (anchoring) sala bilər. Müdaxiləni sadəcə olaraq "xidmət", "etimad" və ya "məcburetmə" kimi təsnif etmək çox vaxt arxada işləyən faktiki identifikasiya olunmuş mexanizmi maskalayır.
Nəşr seçməsi. Vergi əməletməsi üzrə RCT-lər bölgü təmiz təsadüfi olduğu üçün bu problemə qarşı toxunulmaz deyil. Dərc olunmuş xatırlatma ədəbiyyatı birmənalı olaraq işarəyə və əhəmiyyətə görə nəşr seçməsi göstərir. Gələcək hər hansı tədqiqat sintezi axtarış və kodlaşdırma qaydalarını əvvəlcədən qeydiyyata almalı, sıfır nəticələrini (null results) atmayıb saxlamalı, bir tədqiqatdan çıxan çoxsaylı qiymətlər arasındakı asılılığı modelləşdirməli və yanlılıq diaqnostikalarını kənarda bir əlavədə deyil, birbaşa birləşdirilmiş ortanın yanında bildirməlidir.
Ölçmə geri əlaqəsi. Rəqəmsallaşma vergidən yayınmanı həqiqətən kəskin azalda bilər, amma eyni zamanda əvvəllər tamamilə gizli qalan əməletməmə hallarını görünən edə bilər; deməli, davranış reallıqda yaxşılaşdığı halda ölçülən boşluq verilən islahatından sonra kağız üzərində arta bilər. Potensial vergi bazası yeniləndiyi üçün də azala bilər. HMRC-nin öz yenilənmələri və IRS proqnozlarının modelə əsaslanan təbiəti bunun nəzəri bir fərziyyə yox, sırf empirik bir məsələ olduğunu göstərir; deməli, heç bir performans idarəçiliyi (performance management) rejimi, buraxılışa dəqiq nəzarət edən müqayisə olmadan boşluq qiymətindəki aylıq və ya illik hərəkətlər üzərində qurulmamalıdır.
Proqnostik etiketlərdə seçmə. Audit risk modelləri bir qayda olaraq əvvəlki audit seçmə qaydalarının yaratdığı dar verilənlər üzərində öyrədilir, ona görə də tam təsadüfi və ya kəşfiyyat (exploratory) seçmələri olmadan, idarə əks-fakt nəticələrini yalnız özünün əvvəlcədən seçdiyi həmin alt çoxluq üçün müşahidə edə bilir. Təsadüfi audit proqramları isə qərəzsiz yayılma ölçməsinə gedən ən sağlam yoldur və o həm çox bahalıdır, həm də qüsurlu aşkarlayır.
Bu məqalənin yazılması üçün nəzərdən keçirilən üç fundamental məsələ yoxlanıla bilmədi və mənasız, ikinci dərəcəli rəqəmlərlə doldurulmaq əvəzinə, dəqiq boşluq kimi qeyd olunur. Əməkdaşlıq əsaslı əməletmə (cooperative compliance) proqramının düzgün bəyan edilmiş korporativ vergiyə olan birbaşa səbəb təsirini (causal impact), ilkin proqram seçməsindən ayıran heç bir inandırıcı eksperimental və ya kvazi-eksperimental qiymətləndirmə yoxdur. Mənbədən tutulmanı üçüncü tərəf informasiya kanalından xalis şəkildə ayıran, vahid nəticə vahidində verilmiş təmiz ölkələrarası səbəb qiyməti yoxdur, çünki bu ikisi demək olar ki, hər yerdə institusional olaraq tək bir paketdə təqdim edilir. Və əvvəlcədən doldurulmuş bəyannamələr üçün, fərqli dizaynlar arasında parametr kimi sitat gətiriləcək qədər müqayisə oluna bilən hər hansı universal ədədi effekt yoxdur.
Bütün bunlardan sonra, ən böyük həqiqətən açıq sual isə budur: davamlı könüllü əməletmənin tam olaraq nə qədəri məcburetmə potensialından və mövcud informasiya arxitekturasından asılı olmayaraq bilavasitə institusional etimada, prosedur ədalətinə və qarşılıqlılığa aid edilə bilər? Mövcud sorğu sübutları və davranış çərçivələri bu kanalları çox güclü şəkildə motivasiya edir, Almaniyadakı sıfır məcburetmə sahə sübutu isə daxili motivasiyanın doğrudan da mövcudluğunu birbaşa təsdiqləyir. Lakin etimad kanalının ölkələrarası kəmiyyəti, təsadüfi bölüşdürülmüş sadə bir mesajın və ya yoxlana bilən üçüncü tərəf sənəd izinin təsirindən qat-qat zəif identifikasiya olunub və məhz onu eyni səviyyəli, bərabər hüquqlu əmsal kimi oxucuya bildirən məqalələr ən diqqətlə, şübhə ilə oxunmalı olanlardır.
Nəticə
Gəlinən nəticə, sadəcə etimadın, xatırlatmaların və ya rəqəmsallaşmanın könüllü əməletməni artırdığına dair irəli sürülən o ənənəvi, adi iddiadan xeyli dardır. Müasir vergi sistemləri yüksək müşahidə olunan əməletmə göstəricisini bütöv bir portfel vasitəsilə əldə edir: bəzi mexanizmlər birtərəfli yanlış bəyanetmə imkanını tamamilə aradan qaldırır, bəziləri fərdin qavradığı aşkarlanma ehtimalını qaldırır, bəziləri ancaq istəmədən edilən səhvi və əməliyyat xərcini azaldır, bəziləri isə daxili və ya qarşılıqlı motivləri hərəkətə gətirir. Bütün bunlar tamamilə fərqli öhdəliklərə təsir edir və tamamilə fərqli alətlərlə ölçülür; məhz ona görə də vahidi dəyişmədən bunlar arasında gedən hər hansı bir riyazi mühakimə, əsl mühakimə deyil.
Bu məqalədəki işlək kodun yeganə məqsədi məhz bu fərqi ritorik yox, konkret olaraq sübut etməkdir. İyerarxik model, kiçik xananın xam dərəcəsini mütləq fakt saymağın nəyə başa gəldiyini aydın göstərir. Seçmə simulyasiyası, həqiqətin əvvəlcədən məlum olduğu verilənlər üzərində süzgəcin gizlətdiyi dəqiq həqiqətə nisbətən yarıdan çox şişmiş dərc ortasını (published mean) göstərir. Risk modeli rejim dəyişikliyindən sağ çıxan effektiv sıralamanı və eyni zamanda reallıqdan tamamilə uzaqlaşan ehtimalları nümayiş etdirir. İyirmi illik real HMRC verilənləri isə struktur zaman sırası modelinin ən bəsit təsadüfi gəzişməyə belə uduzduğunu, lakin intervallarının isə həmişə dürüst qaldığını göstərir - özü də elə bir seriyada ki, onun 2022-23 dəyəri eyni nəşrin cəmi iki buraxılışı arasında öz dəyərinin üçdə birindən çox hərəkət etmişdir.
Göstərilən bu problemlərin hər biri əslində eyni fundamental xətanın müxtəlif formalarda təzahürüdür: fərqli suallara cavab verən kəmiyyətlərin bir-birinə qarışdırılması. Ölçməni, izahı, səbəb-nəticə müdaxiləsini, risk proqnozlarını və zaman seriyası proqnozlaşdırmasını bir-birindən ayrı saxlamaq sadəcə metodoloji kapriz deyil. Bu, hesablanan rəqəmlərin real olaraq nəyi ifadə etdiyini qoruyub saxlamağın yeganə yoludur.
Mənbələr
54
- Abadie, A., Diamond, A. and Hainmueller, J. (2010). Synthetic Control Methods for Comparative Case Studies. Journal of the American Statistical Association 105(490), 493-505doi.org
- Allingham, M. G. and Sandmo, A. (1972). Income Tax Evasion: A Theoretical Analysis. Journal of Public Economics 1(3-4), 323-338doi.org
- Almunia, M. and López-Rodríguez, D. (2018). Under the Radar: The Effects of Monitoring Firms on Tax Compliance. American Economic Journal: Economic Policy 10(1), 1-38doi.org
- Antinyan, A. and Asatryan, Z. (2025). Nudging for Tax Compliance: A Meta-Analysis. The Economic Journal 135(668), 1033-1068doi.org
- Antinyan, A. and Asatryan, Z. (2025). Replication package for Nudging for Tax Compliancedoi.org
- Bellon, M., Chang, J., Dabla-Norris, E., Khalid, S., Lima, F., Rojas, E. and Villena, P. (2019). Digitalization to Improve Tax Compliance: Evidence from VAT e-Invoicing in Peru. IMF Working Paper 19/231doi.org
- Bellon, M., Dabla-Norris, E., Khalid, S. and Lima, F. (2022). Digitalization to improve tax compliance: Evidence from VAT e-Invoicing in Peru. Journal of Public Economics 210, 104661doi.org
- Bergolo, M., Ceni, R., Cruces, G., Giaccobasso, M. and Perez-Truglia, R. (2023). Tax Audits as Scarecrows: Evidence from a Large-Scale Field Experiment. American Economic Journal: Economic Policy 15(1), 110-153doi.org
- Bott, K. M., Cappelen, A. W., Sørensen, E. Ø. and Tungodden, B. (2020). You've Got Mail: A Randomized Field Experiment on Tax Evasion. Management Science 66(7), 2801-2819doi.org
- Callaway, B. and Sant'Anna, P. H. C. (2021). Difference-in-Differences with Multiple Time Periods. Journal of Econometrics 225(2), 200-230doi.org
- Carrillo, P., Pomeranz, D. and Singhal, M. (2017). Dodging the Taxman: Firm Misreporting and Limits to Tax Enforcement. American Economic Journal: Applied Economics 9(2), 144-164doi.org
- Dwenger, N., Kleven, H. J., Rasul, I. and Rincke, J. (2016). Extrinsic and Intrinsic Motivations for Tax Compliance: Evidence from a Field Experiment in Germany. American Economic Journal: Economic Policy 8(3), 203-232doi.org
- Egger, M., Davey Smith, G., Schneider, M. and Minder, C. (1997). Bias in Meta-Analysis Detected by a Simple, Graphical Test. BMJ 315(7109), 629-634doi.org
- Gneiting, T. and Raftery, A. E. (2007). Strictly Proper Scoring Rules, Prediction, and Estimation. Journal of the American Statistical Association 102(477), 359-378doi.org
- Hallsworth, M., List, J. A., Metcalfe, R. D. and Vlaev, I. (2017). The Behavioralist as Tax Collector. Journal of Public Economics 148, 14-31doi.org
- HM Revenue and Customs (2026). Measuring tax gaps 2026 edition: tax gaps summarygov.uk
- HM Revenue and Customs (2026). Measuring tax gaps: online tablesgov.uk
- International Monetary Fund (2021). The Revenue Administration Gap Analysis Program: VAT Gap Estimation Modelimf.org
- International Monetary Fund. International Survey on Revenue Administration (ISORA) data portaldata.imf.org
- Internal Revenue Service. The Tax Gapirs.gov
- Internal Revenue Service. Tax Gap Projections for Tax Year 2022, Publication 5869irs.gov
- Internal Revenue Service. National Research Program Overview, Internal Revenue Manual 4.22.1irs.gov
- Kirchler, E., Hoelzl, E. and Wahl, I. (2008). Enforced versus voluntary tax compliance: The slippery slope framework. Journal of Economic Psychology 29(2), 210-225doi.org
- Kirchler, E. and Wahl, I. (2010). Tax Compliance Inventory TAX-I: Designing an Inventory for Surveys of Tax Compliance. Journal of Economic Psychology 31(3), 331-346doi.org
- Kleven, H. J., Knudsen, M. B., Kreiner, C. T., Pedersen, S. and Saez, E. (2011). Unwilling or Unable to Cheat? Evidence From a Tax Audit Experiment in Denmark. Econometrica 79(3), 651-692doi.org
- Kotakorpi, K. and Laamanen, J.-P. (2016). Prefilled Income Tax Returns and Tax Compliance: Evidence from a Natural Experiment. Tampere Economic Working Papers 1604ideas.repec.org
- Luttmer, E. F. P. and Singhal, M. (2014). Tax Morale. Journal of Economic Perspectives 28(4), 149-168doi.org
- Naritomi, J. (2019). Consumers as Tax Auditors. American Economic Review 109(9), 3031-3072doi.org
- OECD (2016). Co-operative Tax Compliance: Building Better Tax Control Frameworksdoi.org
- OECD (2020). Tax Administration 3.0: The Digital Transformation of Tax Administrationoecd.org
- OECD (2025). Tax Administration 2025: Comparative Information on OECD and Other Advanced and Emerging Economiesdoi.org
- Okunogbe, O. and Pouliquen, V. (2022). Technology, Taxation, and Corruption: Evidence from the Introduction of Electronic Tax Filing. American Economic Journal: Economic Policy 14(1), 341-372doi.org
- Pomeranz, D. (2015). No Taxation without Information: Deterrence and Self-Enforcement in the Value Added Tax. American Economic Review 105(8), 2539-2569doi.org
- Saez, E. (2010). Do Taxpayers Bunch at Kink Points? American Economic Journal: Economic Policy 2(3), 180-212doi.org
- Simonsohn, U., Nelson, L. D. and Simmons, J. P. (2014). P-Curve: A Key to the File-Drawer. Journal of Experimental Psychology: General 143(2), 534-547doi.org
- Slemrod, J. (2019). Tax Compliance and Enforcement. Journal of Economic Literature 57(4), 904-954doi.org
- Slemrod, J., Blumenthal, M. and Christian, C. (2001). Taxpayer response to an increased probability of audit: evidence from a controlled experiment in Minnesota. Journal of Public Economics 79(3), 455-483doi.org
- Stanley, T. D. and Doucouliagos, H. (2014). Meta-regression approximations to reduce publication selection bias. Research Synthesis Methods 5(1), 60-78doi.org
- Sun, L. and Abraham, S. (2021). Estimating Dynamic Treatment Effects in Event Studies with Heterogeneous Treatment Effects. Journal of Econometrics 225(2), 175-199doi.org
- Tax Administration Diagnostic Assessment Tool (TADAT)tadat.org
- TADAT Performance Assessment Reportstadat.org
- UNU-WIDER (2025). Government Revenue Dataset, version 2025doi.org
- Vehtari, A., Gelman, A., Simpson, D., Carpenter, B. and Bürkner, P.-C. (2021). Rank-Normalization, Folding, and Localization: An Improved R-hat for Assessing Convergence of MCMC. Bayesian Analysis 16(2), 667-718doi.org
- Yitzhaki, S. (1974). A Note on Income Tax Evasion: A Theoretical Analysis. Journal of Public Economics 3(2), 201-202ideas.repec.org
- World Values Survey, documentation and data accessworldvaluessurvey.org
- European Values Study, notes on data access (GESIS)gesis.org
- Afrobarometer dataafrobarometer.org
- Latinobarometro data and documentationlatinobarometro.org
- World Bank Enterprise Surveys dataespanol.enterprisesurveys.org
- PyMC documentation: pymc.samplepymc.io
- ArviZ documentation: arviz.summary and convergence diagnosticspython.arviz.org
- statsmodels documentation: UnobservedComponentsstatsmodels.org
- scikit-learn user guide: Probability calibrationscikit-learn.org
- scikit-learn user guide: Permutation feature importancescikit-learn.org