Çoxdilli Data Science Arxitekturası: Python və R-ı Positron IDE-də Birləşdirmək
Verilənləri Python hazırlayır, R vizuallaşdırır, Quarto isə hər ikisini vahid IDE daxilində tək təkrarlana bilən hesabatda birləşdirir.
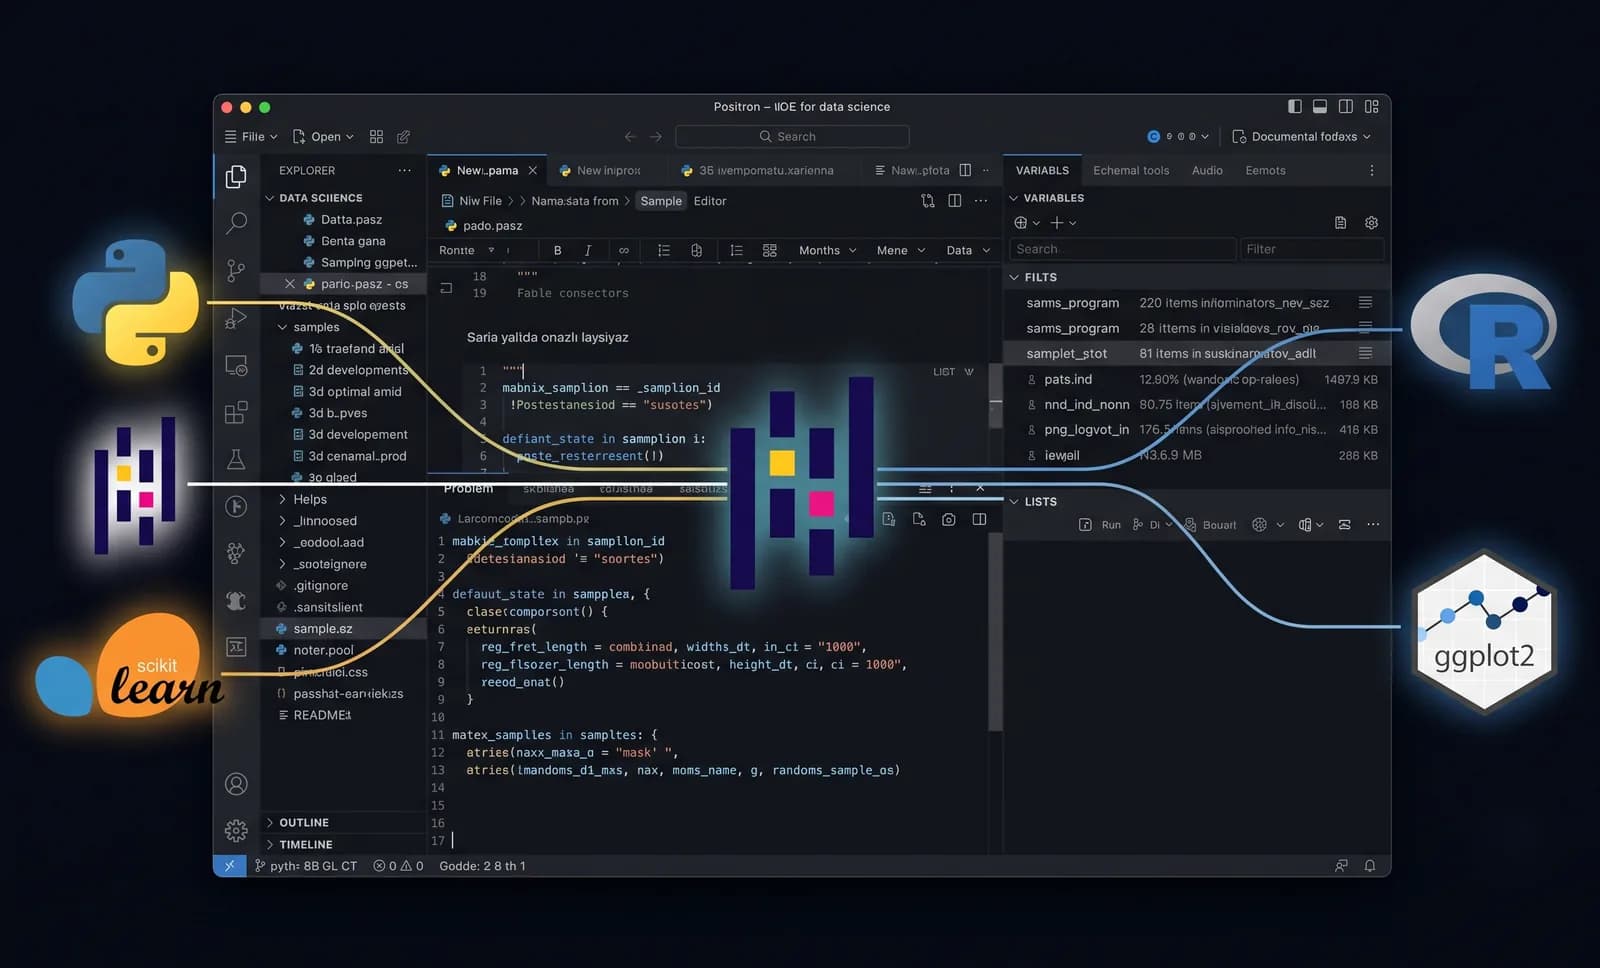
İllərdir məlumat elmi (Data Science) ictimaiyyətində bitmək bilməyən bir mübahisə var: "Python, yoxsa R?" Lakin mürəkkəb statistik modellər quran və arxitektur sistemlər layihələndirən mühəndislər üçün bu sualın özü kökündən yanlışdır. Hər şeyi tək bir dilə sığdırmağa çalışmaq əvəzinə, niyə hər bir dilə ən yaxşı bacardığı işi görməyə icazə verməyək?
Son dövrlərdə sənayedə tətbiq olunan ən effektiv metodologiyalardan biri məhz çoxdilli iş axınlarının (multi-language workflow) qurulmasıdır. Bu məqalədə, xüsusilə yeni nəsil Positron IDE istifadə edərək Python və R-ın eyni layihə daxilində necə mükəmməl sinxronlaşdırıldığını analiz edəcəyik.
Niyə Çoxdilli İş Axını (Multi-Language Workflow)?
Ənənəvi olaraq məlumat alimləri ya Jupyter Notebook (Python üçün), ya da RStudio (R üçün) istifadə edərək eyni mühitə qapanırdılar. Lakin reallıq budur ki:
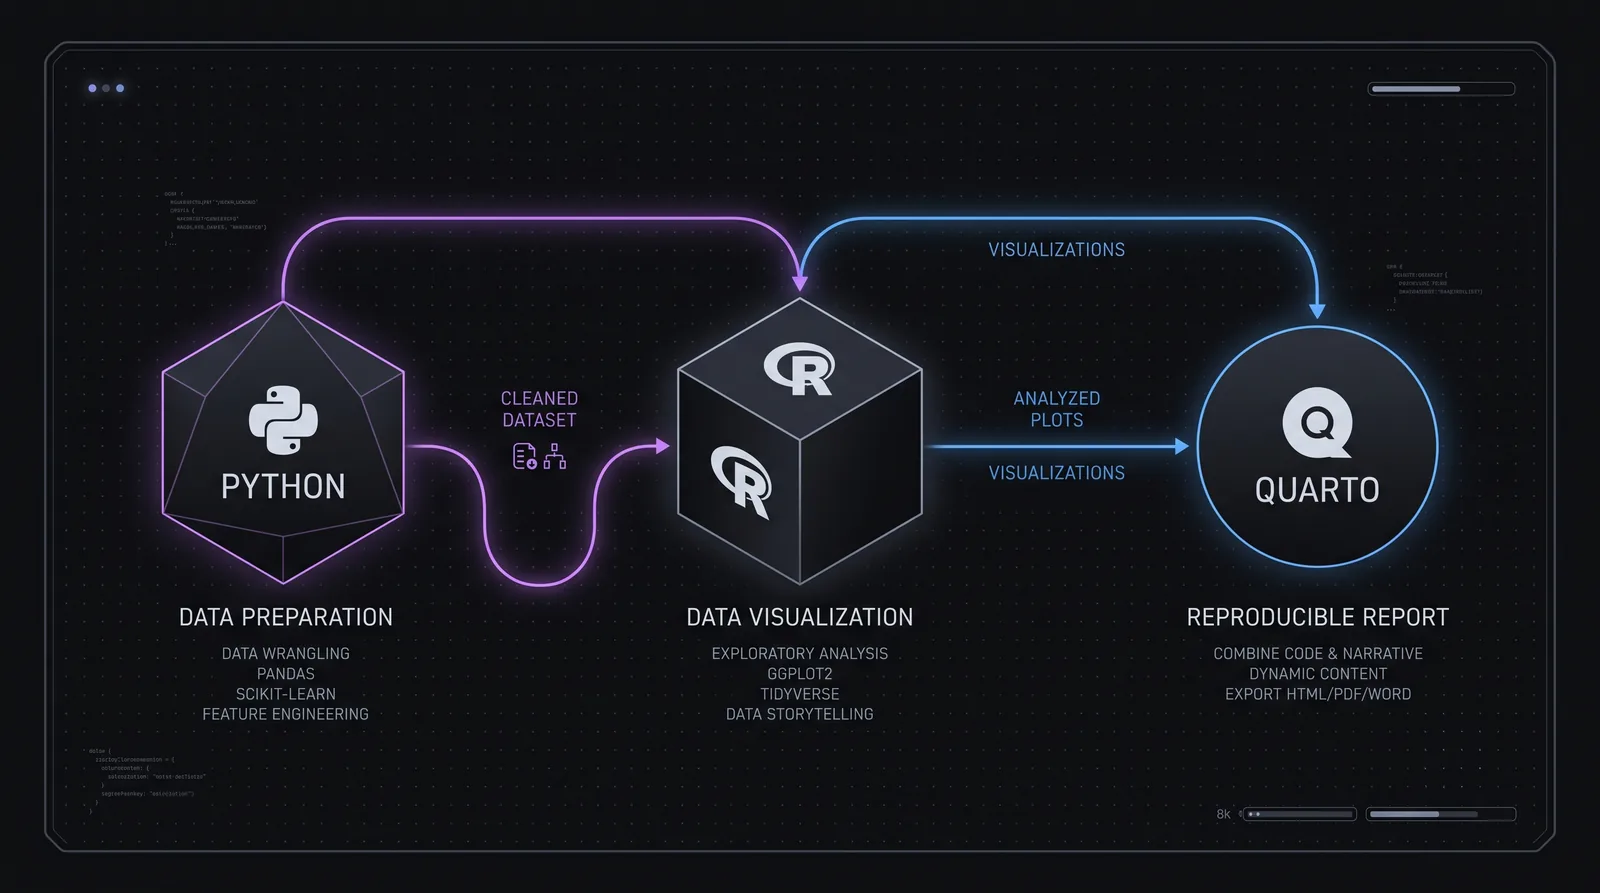
- Python - Verilənlərin miqyaslana bilən formatda hazırlanması (data preparation) və mürəkkəb maşın öyrənməsi (Machine Learning) konveyerlərinin (pipeline) qurulmasında rəqabətsizdir.
- R - Dərin statistik analizlər üçün ideal mühitdir, təbəqəli qrafik qrammatikası (Grammar of Graphics) isə qrafik üzərində Python-un heç bir vizuallaşdırma kitabxanasının vermədiyi dəqiq nəzarəti verir.
Bu müşahidələrin heç biri yeni deyil. Dəyişən odur ki, ikisini birləşdirmək artıq layihə strukturunu qurban vermək bahasına başa gəlmir: bütün ekosistem indi mütəşəkkil və təkrarlana bilən (reproducible) qalaraq tək bir IDE altına sığır.
Positron əslində nə əlavə edir
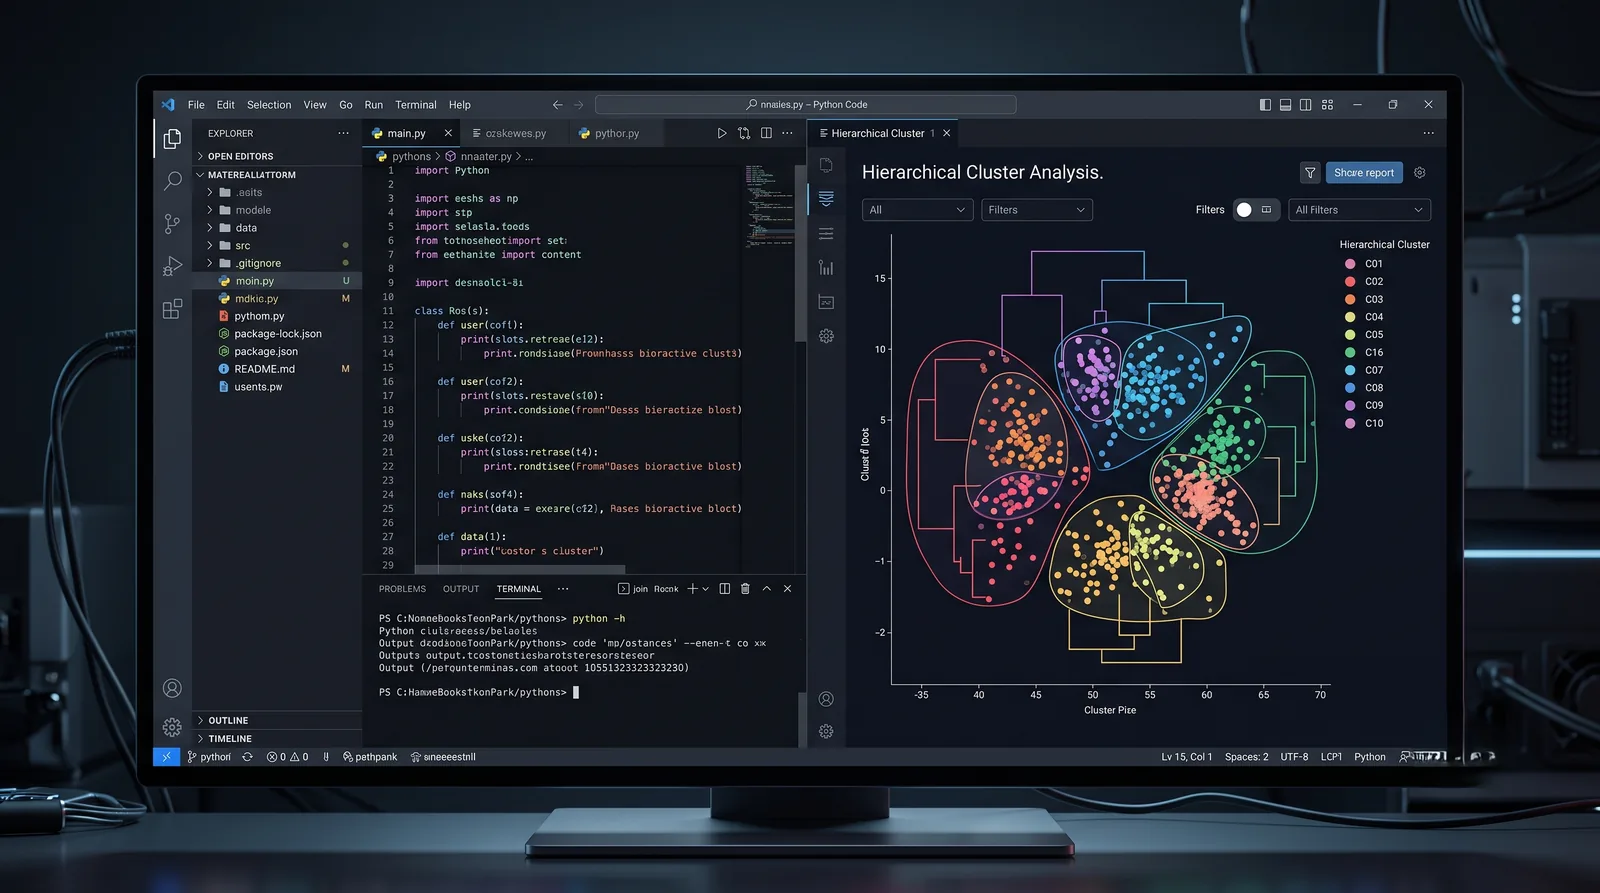
Burada dəqiq olmağa dəyər, çünki "daha yaxşı IDE istifadə et" tövsiyəsi öz-özlüyündə heç nə demir. Positron Posit tərəfindən Code OSS üzərində qurulub, yəni redaktor, genişlənmələr və qısayollar VS Code-dan onsuz da tanıdığınız şeylərdir. Əlavə etdiyi isə budur: sessiya genişlənmə parametri deyil, birinci dərəcəli anlayışdır. İnterpretator seçicisi interfeysin ən üst səviyyəsindədir, konsol aktiv olan Python və ya R sessiyasına qoşulur, Dəyişənlər paneli və data tədqiqatçısı isə hər ikisini oxuyur, hər dil üçün ayrı alət tələb etmir.
Bu, kosmetik səslənir, amma deyil. VS Code və RStudio arasında bölünmüş işdə maneə heç vaxt sintaksis olmur, maneə bir data çərçivəsinə baxmaq üçün onun hansı proqrama aid olduğunu yadda saxlamaq məcburiyyətidir. Bunu tək pəncərəyə yığmaq çoxdilli konveyeri bir dəfə qurulub bir daha toxunulmayan quruluşdan gündəlik işlənə bilən şeyə çevirən amildir.
Positron IDE ilə Praktik İcra
Gəlin bu çoxdilli arxitekturanın real iş mühitində necə qurulduğuna addım-addım baxaq:
1. Data Hazırlığı və Klasterizasiya (Python)
Məlumat bazasından (məsələn, PostgreSQL) xam datanı çəkdikdən sonra ilk mərhələ təmizləmə və ilkin emaldır. Bu mərhələdə verilənlərin hazırlanması və iyerarxik klasterizasiya (hierarchical clustering) kimi maşın öyrənməsi tapşırıqları üçün Python-un ekosistemindən istifadə olunur.
# Python: Verilənlərin hazırlanması və İyerarxik Klasterizasiya
import pandas as pd
from sklearn.cluster import AgglomerativeClustering
from sklearn.preprocessing import StandardScaler

# Datanın emalı
df = pd.read_csv("raw_data.csv")
scaler = StandardScaler()
scaled_data = scaler.fit_transform(df[['feature1', 'feature2']])

# Klaster modelinin qurulması
cluster_model = AgglomerativeClustering(n_clusters=3, linkage='ward')
df['cluster_id'] = cluster_model.fit_predict(scaled_data)

# Nəticəni R üçün yadda saxlamaq
df.to_csv("processed_clusters.csv", index=False)
2. Məlumatların Vizuallaşdırılması (R və ggplot2)
Məlumatlar Python ilə işləndikdən sonra hesabatın vizual keyfiyyətini artırmaq üçün estafet R-a keçir. matplotlib və ya seaborn faydalı olsa da, heç biri R-ın ggplot2 paketinin verdiyi akademik səviyyəli vizuallaşdırma dəqiqliyini və estetik idarəetməni vermir. Bu mərhələdə R məhz məlumatların vizuallaşdırılması (data visualization) üçün dövrəyə girir.
# R: ggplot2 ilə Məlumat Vizuallaşdırılması
library(ggplot2)
library(readr)

# Python-dan gələn datanın oxunması
df_clusters <- read_csv("processed_clusters.csv")

# Akademik səviyyəli plot
ggplot(df_clusters, aes(x = feature1, y = feature2, color = as.factor(cluster_id))) +
  geom_point(size = 3, alpha = 0.8) +
  theme_minimal() +
  labs(title = "İyerarxik Klasterizasiyanın Nəticələri",
       color = "Klaster")
3. Təkrarlana Bilən (Reproducible) Hesabatların Yaradılması (Quarto)
Tədqiqatın və ya analiz nəticələrinin B2B partnyorlara və ya rəhbərliyə təqdim olunması mühəndislik işinin ən həlledici nöqtəsidir. Kod bloklarının kopyalanıb yapışdırılması dövrü artıq bitib. Bütün bu iş axını təkrarlana bilən HTML hesabatları yaratmaq üçün Quarto vasitəsilə birləşdirilir. Quarto həm Python, həm də R kod bloklarını eyni sənəd daxilində (render edərək) oxuya bilir.
Yekun Düşüncələr
Bir Data Scientist kimi davamlı olaraq fərqli dillər arasında keçid etmək məcburiyyətində qalırıq. Positron IDE-nin təqdim etdiyi bu yeni arxitektura, fərqli alətlər (VS Code, Jupyter, RStudio) arasında yaranan kontekst itkisini sıfıra endirir. Bütün iş axınını tək bir IDE daxilində cəmləmək həm dillər arası keçidi asanlaşdırır, həm də layihələrinizi tam təkrarlana bilən (reproducible) və strukturlaşdırılmış vəziyyətdə saxlayır.
Sistemlərin arxitekturasında olduğu kimi, analiz prosesində də "Microservices" məntiqi keçərlidir: Monolit sistemlər yerinə, hər işi ən mükəmməl edən aləti seçin və onları düzgün konveyer (pipeline) ilə bir-birinə bağlayın.